¿Cómo se distribuyen las clases y las categorías A–D de B3DB? ¿Se justifica entrenar solo con A+B?
¿Los descriptores fisicoquímicos clásicos separan las clases en estos datos, o solo en la literatura?
¿Qué tan diversa es la estructura? ¿Alcanza para un scaffold split?
¿El conjunto de validación externa es utilizable?
¿Los productos naturales cruzan la barrera igual que el resto? Es la pregunta central del proyecto, y se contesta en la §5.
Advertencia metodológica. No se usan cifras de desempeño de la literatura como referencia. Los baselines publicados para el mismo conjunto varían entre 0.681 y 0.7194 según quién los reporte, por implementaciones distintas del scaffold split. Todo número aquí se calcula sobre los datos descargados.
1. Preparación
Código
import warningswarnings.filterwarnings("ignore")from pathlib import Pathimport numpy as npimport pandas as pdimport matplotlib.pyplot as pltimport seaborn as snsfrom rdkit import Chem, RDLoggerfrom rdkit.Chem import Descriptors, rdMolDescriptorsfrom rdkit.Chem.Scaffolds import MurckoScaffoldfrom scipy.stats import chi2_contingencyfrom sklearn.metrics import (average_precision_score, balanced_accuracy_score, matthews_corrcoef, roc_auc_score, roc_curve)RDLogger.DisableLog("rdApp.*") # el parseo se audita explícitamente más abajosns.set_theme(style="whitegrid", palette="colorblind")plt.rcParams["figure.dpi"] =110RAIZ = Path.cwd().parent if Path.cwd().name =="notebooks"else Path.cwd()DIR_FIGURAS = RAIZ /"docs"/"reportes"/"avance-1"DIR_FIGURAS.mkdir(parents=True, exist_ok=True)EXT = RAIZ /"data"/"external"print("RDKit", Chem.rdBase.rdkitVersion, "| descriptores 2D disponibles:", len(Descriptors._descList))
La fuente primaria de este análisis es el conjunto curado por la patrocinadora, bbb_permeability_experimental.csv, entregado el 25 de septiembre junto con su diccionario de columnas. Los archivos de B3DB que el equipo descargó por su cuenta se conservan como verificación complementaria: permiten contrastar el conteo, confirmar de forma independiente los problemas de calidad y recuperar el detalle del archivo de regresión.
El conjunto de la patrocinadora aporta sobre el original tres cosas que este análisis aprovecha:
Aporte
Para qué sirve aquí
SMILES estandarizados con RDKit (sal retirada, cargas neutralizadas, tautómero canónico)
Elimina una fuente de variación que no es química
key14 precalculado
El esqueleto de conectividad sin estereoquímica, que mide el tamaño efectivo de muestra
Cruce estructural con COCONUT
Permite separar productos naturales de sintéticos, que es el objetivo del proyecto
El último es el decisivo: sin él no podríamos preguntar si los compuestos que nos interesan priorizar se comportan distinto frente a la barrera.
Código
# Fuente primaria: el conjunto curado por la patrocinadora.PROF = EXT /"profesora"/"bbb_permeability_experimental.csv"b3db = pd.read_csv(PROF)b3db.columns = [c.strip().lstrip("\ufeff") for c in b3db.columns]# Se renombran las columnas a los nombres que usa el resto del notebook.b3db = b3db.rename(columns={"smiles_std": "SMILES", # ya estandarizado con RDKit"bbb_class": "BBB+/BBB-","logbb": "logBB","b3db_threshold": "threshold","b3db_uncertainty_classification": "group","b3db_reference_classification": "reference","inchikey": "Inchi",})# Archivos de B3DB descargados por el equipo: verificación complementaria.crudo = pd.read_csv(EXT /"b3db"/"B3DB_classification.tsv", sep="\t")ext = pd.read_csv(EXT /"b3db"/"B3DB_classification_external.tsv", sep="\t")reg = pd.read_csv(EXT /"b3db"/"B3DB_regression.tsv", sep="\t")print(f"patrocinadora : {len(b3db):>5} filas · {len(b3db.columns)} columnas")print(f" con clase BBB+/BBB- : {b3db['BBB+/BBB-'].notna().sum():>5}")print(f" con logBB numérico : {b3db['logBB'].notna().sum():>5}")print(f" con equivalente en COCONUT : {b3db['coconut_id_exact_match'].notna().sum():>5}")print()print(f"B3DB crudo (complementario) : {len(crudo):>5} clasificación · {len(ext)} externo · {len(reg)} regresión")b3db.head(3)
patrocinadora :  7811 filas · 16 columnas
  con clase BBB+/BBB-        :  7805
  con logBB numérico         :  1058
  con equivalente en COCONUT :  3366

B3DB crudo (complementario) :  7807 clasificación · 175 externo · 1058 regresión
Inchi
key14
SMILES
compound_name
BBB+/BBB-
logBB
threshold
group
b3db_uncertainty_regression
reference
b3db_reference_regression
source_id_classification
source_id_regression
coconut_id_exact_match
coconut_ids_key14_match
coconut_matches_key14
0
AABLHGPVOULICI-BRJGLHKUSA-N
AABLHGPVOULICI
CN1CC[C@]23c4c5ccc(O)c4O[C@H]2[C@@H](O)CC[C@@]...
hydromorphinol
BBB+
NaN
-1.0
B
NaN
R1|R6|R27|R30|
NaN
b3db_classification:1875
NaN
CNP0129509.1
CNP0129509.1
1
1
AABLHGPVOULICI-GYRMQKGHSA-N
AABLHGPVOULICI
CN1CC[C@@]23c4c5ccc(O)c4O[C@H]2[C@H](O)CC[C@@]...
hydromorphinol
BBB+
NaN
NaN
C
NaN
R27|R30|
NaN
b3db_classification:7297
NaN
CNP0129509.1
CNP0129509.1
1
2
AABLHGPVOULICI-UHFFFAOYSA-N
AABLHGPVOULICI
CN1CCC23c4c5ccc(O)c4OC2C(O)CCC3(O)C1C5
hydromorphinol
BBB+
NaN
-1.0
B
NaN
R19|R27|
NaN
b3db_classification:4469
NaN
CNP0129509.1
CNP0129509.1
1
Forma y tipos de datos del archivo principal, antes de tocarlo:
Cardinalidad de las columnas categóricas y de texto
La forma y los tipos no dicen qué papel puede cumplir cada columna de texto. El número de niveles distintos sí: una columna con casi un nivel por fila es un identificador, no una variable; una con pocos niveles puede ser una categoría. La tabla se calcula sobre el archivo completo recién cargado (7,811 filas).
Código
texto = b3db.select_dtypes(include="object").columnsimplica = {"Inchi": "identificador de estructura (con estereoquímica); sirve para deduplicar, no como variable","key14": "identificador del esqueleto de conectividad; sirve para agrupar, no como variable","SMILES": "la estructura; es la entrada de los descriptores, no una variable por sí misma","compound_name": "identificador casi único (un nombre distinto por cada 1.3 filas que tienen nombre) y con 14% de faltantes: no es una variable. No se usa para modelar","BBB+/BBB-": "la etiqueta (2 niveles)","group": "4 niveles (A–D): se usa para estratificar, nunca como predictor ni como filtro (decisión 1.1)","b3db_uncertainty_regression": "4 niveles, solo en las filas con logBB; metadato de la regresión, no predictor","reference": "lista de referencias separadas por «|»: casi única por fila, se resume contando (nref), no como categoría","b3db_reference_regression": "lista de referencias de la regresión: casi única por fila, solo en las filas con logBB","source_id_classification": "identificador de procedencia del registro (uno por fila)","source_id_regression": "identificador de procedencia del registro de regresión (uno por fila con logBB)","coconut_id_exact_match": "identificador de COCONUT; solo importa si existe o no (define «natural», §5)","coconut_ids_key14_match": "identificadores de COCONUT por esqueleto; mismo uso, más permisivo que el exacto",}card = pd.DataFrame({"niveles distintos": [b3db[c].nunique() for c in texto],"% del total de filas": [round(b3db[c].nunique() /len(b3db) *100, 1) for c in texto],"faltantes": [int(b3db[c].isna().sum()) for c in texto],"implicación": [implica.get(c, "—") for c in texto],}, index=texto).sort_values("niveles distintos", ascending=False)pd.set_option("display.max_colwidth", 110)print(f"{len(card)} columnas de texto; {len(b3db):,} filas\n")print(card.to_string())
13 columnas de texto; 7,811 filas

                             niveles distintos  % del total de filas  faltantes                                                                                                                                            implicación
Inchi                                     7808                 100.0          0                                                              identificador de estructura (con estereoquímica); sirve para deduplicar, no como variable
SMILES                                    7808                 100.0          0                                                                         la estructura; es la entrada de los descriptores, no una variable por sí misma
source_id_classification                  7805                  99.9          6                                                                                               identificador de procedencia del registro (uno por fila)
compound_name                             5095                  65.2       1109  identificador casi único (un nombre distinto por cada 1.3 filas que tienen nombre) y con 14% de faltantes: no es una variable. No se usa para modelar
key14                                     4019                  51.5          0                                                                      identificador del esqueleto de conectividad; sirve para agrupar, no como variable
coconut_ids_key14_match                   2019                  25.8       3440                                                                       identificadores de COCONUT por esqueleto; mismo uso, más permisivo que el exacto
coconut_id_exact_match                    1498                  19.2       4445                                                                           identificador de COCONUT; solo importa si existe o no (define «natural», §5)
source_id_regression                      1058                  13.5       6753                                                                        identificador de procedencia del registro de regresión (uno por fila con logBB)
reference                                  877                  11.2          6                                              lista de referencias separadas por «|»: casi única por fila, se resume contando (nref), no como categoría
b3db_reference_regression                  474                   6.1       6753                                                                 lista de referencias de la regresión: casi única por fila, solo en las filas con logBB
group                                        4                   0.1          6                                                          4 niveles (A–D): se usa para estratificar, nunca como predictor ni como filtro (decisión 1.1)
b3db_uncertainty_regression                  4                   0.1       6753                                                                         4 niveles, solo en las filas con logBB; metadato de la regresión, no predictor
BBB+/BBB-                                    2                   0.0          6                                                                                                                                la etiqueta (2 niveles)
Lectura. Cuatro columnas son identificadores y no variables: Inchi y SMILES (7,808 niveles distintos en 7,811 filas, es decir, solo tres filas repiten estructura exacta, lo mismo que encuentra la §2.4), source_id_classification (uno por registro) y compound_name (5,095 niveles, 65.2% de las filas y 76% de las que tienen nombre, con 14% de faltantes). key14 (4,019 niveles, 51.5%) es el identificador del esqueleto y sirve para agrupar en la partición, no para predecir. reference y b3db_reference_regression son listas de referencias, casi únicas: se resumen contando, no como categoría. Las dos columnas de COCONUT tienen cientos o miles de niveles y solo interesa si el dato existe. Las únicas categóricas de verdad son BBB+/BBB- (2 niveles), group (4 niveles; estratificar, nunca predecir ni filtrar, decisión 1.1) y b3db_uncertainty_regression (4 niveles, solo en las filas con logBB). Ninguna columna de texto es candidata a variable de entrada, así que no hay codificación de categóricas que decidir en el Avance 2 para este archivo.
2.1 El conteo de 7,807 contra 7,982
El README de B3DB reporta 7,982 compuestos y el archivo principal tiene 7,807. No es una discrepancia de versión: los 175 agregados en agosto de 2025 viven en un archivo aparte que no se fusionó. Pero no se pueden concatenar a ciegas.
Código
# Dos archivos de clasificación de B3DB y su solapamiento.solapan =set(crudo["Inchi"].dropna()) &set(ext["Inchi"].dropna())print(f"B3DB publica dos archivos de clasificación: {len(crudo):,} + {len(ext)} = {len(crudo)+len(ext):,}")print(f" compuestos presentes en ambos (InChI exacto): {len(solapan)}")print(f" concatenarlos a ciegas produciría {len(solapan)} duplicados")# ¿Cuántos de los 175 del suplemento están en el archivo de la patrocinadora?# El InChIKey se recalcula desde el SMILES en ambos lados (no se usa la columna Inchi del archivo).def _inchikey(s): m = Chem.MolFromSmiles(s)return Chem.MolToInchiKey(m) if m isnotNoneelseNoneclaves_pat = {k for k inmap(_inchikey, b3db["SMILES"]) if k}claves_ext = [k for k inmap(_inchikey, ext["SMILES"]) if k]esq_pat = {k[:14] for k in claves_pat}en_exacto =sum(k in claves_pat for k in claves_ext)en_esqueleto =sum(k[:14] in esq_pat for k in claves_ext)print(f"\nsuplemento de agosto de 2025: {len(claves_ext)} compuestos con InChIKey calculable")print(f" presentes en el archivo de la patrocinadora (InChIKey completo): {en_exacto}")print(f" ausentes : {len(claves_ext) - en_exacto}")print(f" presentes por esqueleto (primeros 14 caracteres) : {en_esqueleto}")print(f" ausentes por esqueleto : {len(claves_ext) - en_esqueleto}")# El archivo tiene una fila por registro estandarizado, no por compuesto: se ve en la §2.4.print(f"\nfilas del archivo: {len(b3db):,} · InChIKey (columna Inchi) distintos: {b3db['Inchi'].nunique():,}"f" · esqueletos (key14) distintos: {b3db['key14'].nunique():,}")
B3DB publica dos archivos de clasificación: 7,807 + 175 = 7,982
  compuestos presentes en ambos (InChI exacto): 11
  concatenarlos a ciegas produciría 11 duplicados

suplemento de agosto de 2025: 175 compuestos con InChIKey calculable
  presentes en el archivo de la patrocinadora (InChIKey completo): 11
  ausentes                                                      : 164
  presentes por esqueleto (primeros 14 caracteres)              : 86
  ausentes por esqueleto                                        : 89

filas del archivo: 7,811 · InChIKey (columna Inchi) distintos: 7,808 · esqueletos (key14) distintos: 4,019
Qué resuelve el archivo de la patrocinadora y qué no.
Sí resuelve la unión de la clasificación con la regresión por estructura (1,058 valores de logBB, los mismos que el archivo de regresión de B3DB), los SMILES estandarizados, los dos SMILES inválidos del archivo crudo y el cruce con COCONUT.
No incorpora el suplemento de agosto de 2025. La celda anterior lo comprueba recalculando el InChIKey desde el SMILES: de los 175 compuestos del suplemento, 11 están en el archivo (InChIKey completo) y 164 no; por esqueleto de conectividad (primeros 14 caracteres) hay 86 presentes y 89 ausentes. Esos compuestos no se incorporan en esta fase; es una limitación conocida y se declara en lugar de fusionar archivos a ciegas.
No es «un compuesto por fila». Cada fila es un registro estandarizado, y un mismo compuesto aparece varias veces como estereoisómero o duplicado: la §2.4 encuentra InChIKey completos repetidos (primera celda de la sección) y miles de filas que repiten un esqueleto ya visto (3,787 duplicados por esqueleto; 4,018 esqueletos únicos entre 7,805 filas, segunda celda de la sección). El tamaño efectivo de muestra es el número de esqueletos, no el de filas.
2.2 Validez de los SMILES
Código
def a_mol(s):try:return Chem.MolFromSmiles(s)exceptException:returnNoneb3db["mol"] = b3db["SMILES"].map(a_mol)malos = b3db[b3db["mol"].isna()]print(f"SMILES faltantes : {b3db['SMILES'].isna().sum()}")print(f"SMILES que NO parsean en RDKit: {len(malos)} de {len(b3db)}\n")for _, r in malos.iterrows():print(f" fila {r.name} · grupo {r['group']} · {r['BBB+/BBB-']}")print(f" nombre: {r['compound_name']}")print(f" SMILES: {r['SMILES']}")
SMILES faltantes : 0
SMILES que NO parsean en RDKit: 0 de 7811
El diccionario de la patrocinadora identifica los dos registros inválidos como mepenzolato y tiotidina, indica que sus SMILES de B3DB contienen [C+](O) y que fueron excluidos del archivo curado. Como las cadenas no parsean, no reconstruimos ni comparamos sus estructuras en este análisis.
Por tanto, no se infiere que los dos registros correspondan a la misma molécula ni se utiliza esta anomalía para interpretar group como una categoría de calidad.
Código
# Verificación complementaria contra los archivos crudos de B3DB.malos_crudo = [s for s in crudo["SMILES"] if a_mol(s) isNone]print(f"B3DB crudo : {len(malos_crudo)} SMILES inválidos de {len(crudo)}")for nombre, df in [("external", ext), ("regression", reg)]: n =sum(a_mol(s) isNonefor s in df["SMILES"])print(f"{nombre:>18}: {n} SMILES inválidos de {len(df)}")print()print(f"Archivo de la patrocinadora: {b3db['mol'].isna().sum()} SMILES inválidos de {len(b3db)}")print(" (ya vienen excluidos: su curación los retiró)")# se trabaja solo con las filas que tienen clase asignadab3db = b3db.dropna(subset=["mol", "BBB+/BBB-"]).reset_index(drop=True)print(f"\nconjunto de trabajo: {len(b3db)} compuestos con clase y estructura válida")
B3DB crudo        : 2 SMILES inválidos de 7807
          external: 0 SMILES inválidos de 175
        regression: 0 SMILES inválidos de 1058

Archivo de la patrocinadora: 0 SMILES inválidos de 7811
  (ya vienen excluidos: su curación los retiró)

conjunto de trabajo: 7805 compuestos con clase y estructura válida
2.3 Valores faltantes por columna
Más allá de SMILES, conviene revisar las demás columnas del archivo: varias traen huecos considerables y conviene saber cuáles antes de decidir qué se usa más adelante.
Código
# Valores faltantes en TODAS las columnas del archivo de la patrocinadora.faltantes = b3db.drop(columns=["mol"], errors="ignore").isna().sum().sort_values(ascending=False)tabla = faltantes.to_frame("faltantes").assign(**{"%": (faltantes /len(b3db) *100).round(1)})print(f"{len(b3db)} filas · {len(tabla)} columnas\n")print(tabla.to_string())numericas_originales = ["logBB", "threshold", "coconut_matches_key14"]resumen_numerico = b3db[numericas_originales].describe().T[["count", "mean", "std", "50%", "min", "max"]]resumen_numerico.columns = ["n válido", "media", "DE", "mediana", "mínimo", "máximo"]print("\nEstadísticas descriptivas de las variables numéricas originales (con clase):")print(resumen_numerico.round(2).to_string())
Los huecos no son errores, son estructurales. Las cuatro columnas del lado de regresión que faltan en el 86.5% —logBB, b3db_uncertainty_regression, b3db_reference_regression y source_id_regression— coinciden con las filas que no tienen logBB medido dentro del conjunto de trabajo: 1,052 de 7,805 sí lo tienen. En el archivo completo hay 1,058 valores de logBB; seis corresponden a registros cuya etiqueta BBB de B3DB no se integró porque, según el diccionario de la patrocinadora, la fila de clasificación tenía otra forma estereoquímica y no coincidió en la unión por estructura. threshold falta en A, C y D; los 3,621 valores presentes pertenecen a B y son −1. Los campos de COCONUT faltan cuando no hay coincidencia estructural para el tipo de cruce correspondiente. compound_name es un metadato descriptivo que no se usa para modelar.
Las columnas que sí importan —SMILES, BBB+/BBB-, Inchi, key14, group— no tienen ningún faltante.
2.3b Patrones de ausencia contra la etiqueta
Que falten valores no es un problema si la ausencia es independiente de la clase; sí lo es si se asocia a ella, porque entonces la presencia del dato filtra información sobre la etiqueta. Para cada columna con faltantes se compara el porcentaje de faltantes en BBB+ y BBB−, y en cada grupo A–D, con una prueba χ² de independencia (valores p sin corregir por comparaciones múltiples; con n = 7,805 la prueba detecta diferencias muy pequeñas, por eso se muestran también los porcentajes).
Código
cols_falt = [c for c in b3db.columns.drop("mol") if b3db[c].isna().any()]filas = []for c in cols_falt: falta = b3db[c].isna() por_clase = falta.groupby(b3db["BBB+/BBB-"]).mean() *100 por_grupo = falta.groupby(b3db["group"]).mean() *100 p_clase = chi2_contingency(pd.crosstab(falta, b3db["BBB+/BBB-"]))[1] p_grupo = chi2_contingency(pd.crosstab(falta, b3db["group"]))[1] filas.append({"columna": c, "% falta": round(falta.mean() *100, 1),"% falta BBB+": round(por_clase["BBB+"], 1), "% falta BBB−": round(por_clase["BBB-"], 1),"p (clase)": f"{p_clase:.1e}",**{f"% falta {g}": round(por_grupo[g], 1) for g in"ABCD"},"p (grupo)": f"{p_grupo:.1e}"})aus = pd.DataFrame(filas).set_index("columna").sort_values("% falta", ascending=False)print(aus.to_string())
                             % falta  % falta BBB+  % falta BBB− p (clase)  % falta A  % falta B  % falta C  % falta D p (grupo)
columna
logBB                           86.5          81.3          95.5   8.6e-70        0.6      100.0      100.0      100.0   0.0e+00
b3db_uncertainty_regression     86.5          81.3          95.5   8.6e-70        0.6      100.0      100.0      100.0   0.0e+00
source_id_regression            86.5          81.3          95.5   8.6e-70        0.6      100.0      100.0      100.0   0.0e+00
b3db_reference_regression       86.5          81.3          95.5   8.6e-70        0.6      100.0      100.0      100.0   0.0e+00
coconut_id_exact_match          56.9          64.2          44.2   3.9e-66       60.9       59.8       52.8        9.8   1.3e-18
threshold                       53.6          49.8          60.2   1.6e-18      100.0        0.0      100.0      100.0   0.0e+00
coconut_ids_key14_match         44.0          56.2          22.9  4.7e-178       53.1       50.3       34.1        5.9   7.6e-53
compound_name                   14.2          12.9          16.6   7.1e-06        1.9       16.6       15.9        0.0   2.4e-35
Lectura. La ausencia sí está asociada a la clase en las ocho columnas con faltantes (todas con p < 1e-5 sin corregir; 0.0e+00 es subdesbordamiento, p < 1e-300). Pero la asociación casi siempre pasa por group, no por la química: las cuatro columnas de regresión faltan en el 81.3% de BBB+ y en el 95.5% de BBB−, y eso porque solo el grupo A tiene logBB (0.6% de faltantes en A contra 100% en B, C y D) y A es 12.1% BBB−. threshold es el espejo: solo está completo en B (0% de faltantes), y falta más en BBB− (60.2%) que en BBB+ (49.8%) por la misma composición de grupos. Los campos de COCONUT faltan menos en BBB− (44.2% y 22.9%) que en BBB+ (64.2% y 56.2%): es la misma observación de la §5 (los naturales son más a menudo BBB−) vista desde el otro lado. compound_name es la diferencia más pequeña (12.9% contra 16.6%) y solo es significativa por el tamaño de muestra.
Consecuencia.Que un dato exista o no filtra información sobre la etiqueta, así que ninguna de estas columnas ni su indicador de «presente» deben entrar como variable de entrada: serían una pista de la procedencia del registro y no de la estructura. Esto refuerza que el modelo se alimenta solo del SMILES (decisión 1.1 para group). Se reportó sobre las 7,805 filas con clase; las seis sin clase no entran en la comparación.
2.4 Duplicados por estructura
La columna Inchi viene del archivo. Aquí se recalcula el InChIKey desde el SMILES con RDKit, que es la forma correcta de deduplicar: detecta compuestos idénticos escritos con SMILES distintos.
Código
b3db["inchikey"] = [Chem.MolToInchiKey(m) for m in b3db["mol"]]b3db["esqueleto"] = b3db["inchikey"].str[:14] # primeros 14 = conectividad, ignora estéreo e isótoposdup_exacto = b3db["inchikey"].duplicated().sum()dup_esq = b3db["esqueleto"].duplicated().sum()print(f"duplicados por InChIKey completo (estéreo incluido): {dup_exacto}")print(f"duplicados por esqueleto (ignorando estereoquímica): {dup_esq}")# ¿hay duplicados con etiquetas EN CONFLICTO? Esto es lo que de verdad importa.conf = (b3db.groupby("inchikey")["BBB+/BBB-"].nunique() >1)claves_conf = conf[conf].indexprint(f"\ncompuestos duplicados con etiquetas CONTRADICTORIAS: {len(claves_conf)}")iflen(claves_conf):print(b3db[b3db["inchikey"].isin(claves_conf)] [["compound_name","BBB+/BBB-","group","inchikey"]] .sort_values("inchikey").to_string(index=False))
duplicados por InChIKey completo (estéreo incluido): 3
duplicados por esqueleto (ignorando estereoquímica): 3787

compuestos duplicados con etiquetas CONTRADICTORIAS: 0
Los tres duplicados por InChIKey completo cargan la misma etiqueta en ambas filas, así que no introducen conflicto: son el mismo compuesto registrado dos veces (o, en el caso de ampicilina/sultamicilina, un profármaco cuya estructura estandarizada colapsa en la del fármaco). El esqueleto de conectividad, en cambio, sí muestra redundancia masiva. Vale la pena medir qué significa eso para el tamaño real de la muestra.
Código
g = b3db.groupby("esqueleto")["BBB+/BBB-"].agg(["nunique","size"])conf_esq = g[g["nunique"] >1]print(f"filas en el conjunto : {len(b3db)}")print(f"esqueletos de conectividad únicos: {b3db['esqueleto'].nunique()}")print(f"\n>> el tamaño EFECTIVO de muestra es {b3db['esqueleto'].nunique()}, no {len(b3db)}")print(f"\nesqueletos con etiquetas CONTRADICTORIAS entre sus estereoisómeros: {len(conf_esq)}")print(f"compuestos afectados: {conf_esq['size'].sum()} ({conf_esq['size'].sum()/len(b3db)*100:.1f}%)")print(f"\ndistribución de multiplicidad por esqueleto:")print(g["size"].value_counts().sort_index().head(8).to_string())print("\nejemplos de esqueletos muy repetidos:")for esq in g.sort_values("size", ascending=False).head(3).index: sub = b3db[b3db["esqueleto"] == esq] nombres = [str(x) for x in sub["compound_name"].head(4) ifstr(x) !="nan"]print(f" {esq} n={len(sub)} clases={dict(sub['BBB+/BBB-'].value_counts())}")print(f" {', '.join(nombres)}")
filas en el conjunto            : 7805
esqueletos de conectividad únicos: 4018

>> el tamaño EFECTIVO de muestra es 4018, no 7805

esqueletos con etiquetas CONTRADICTORIAS entre sus estereoisómeros: 131
compuestos afectados: 429 (5.5%)

distribución de multiplicidad por esqueleto:
size
1    2528
2     443
3     455
4     189
5     218
6     127
7      48
8       8

ejemplos de esqueletos muy repetidos:
  IECPWNUMDGFDKC  n=9  clases={'BBB-': np.int64(8), 'BBB+': np.int64(1)}
    sr-05000001633, fusidic-acid, fusidic acid
  KMIPKYQIOVAHOP  n=9  clases={'BBB-': np.int64(9)}
    cefditoren, (6r)-7-[[(2z)-2-(2-amino-1,3-thiazol-4-yl)-2-methoxyiminoacetyl]amino]-3-[(z)-2-(4-methyl-1,3-thiazol-5-yl)ethenyl]-8-oxo-5-thia-1-azabicyclo[4.2.0]oct-2-ene-2-carboxylic acid
  XSFJVAJPIHIPKU  n=8  clases={'BBB+': np.int64(7), 'BBB-': np.int64(1)}
    77326-96-6, schembl19681909
Esto matiza el titular de “7,807 compuestos”. Entradas como la morfina aparecen ocho veces —como estereoisómeros o duplicados de nombre distinto—, y la codeína conviven con la isocodeína y con su nombre sistemático. La información independiente es cercana a la mitad de lo que sugiere el conteo de filas.
Dos consecuencias prácticas:
El scaffold split es aún más necesario. Un split aleatorio pondría estereoisómeros del mismo compuesto en entrenamiento y prueba, lo que infla el desempeño sin que el modelo generalice a química nueva.
Los esqueletos con etiquetas contradictorias entre estereoisómeros son candidatos a acantilados de actividad genuinos o a inconsistencias de etiquetado. Conviene revisarlos antes de entrenar, no después.
3. Distribución de clases y categorías B3DB
Código
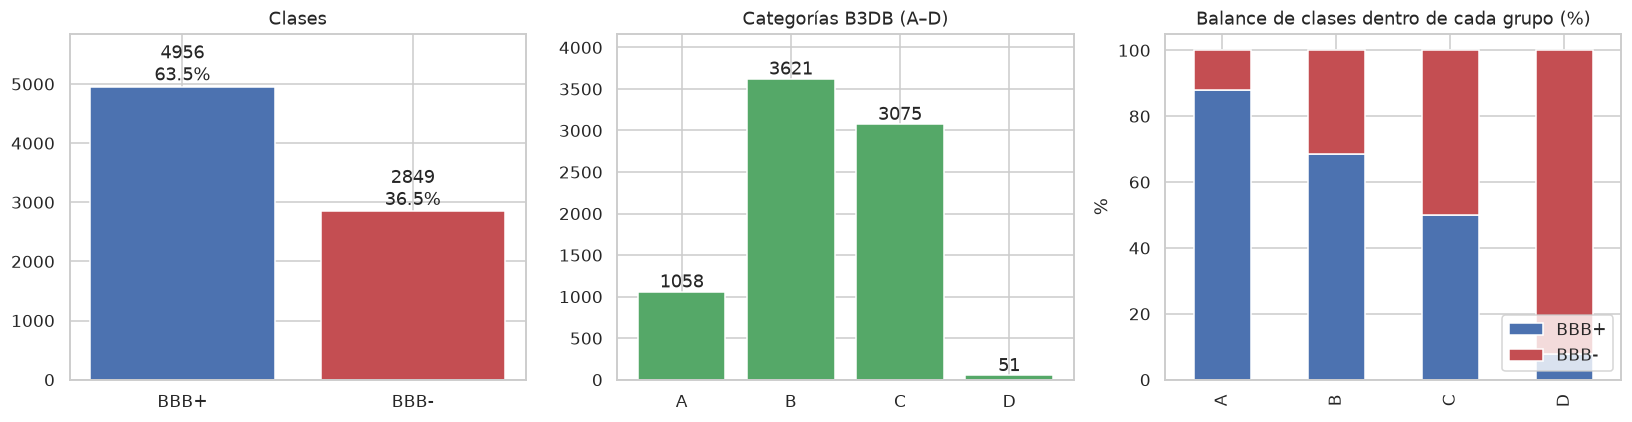
fig, axes = plt.subplots(1, 3, figsize=(15, 4))cls = b3db["BBB+/BBB-"].value_counts()axes[0].bar(cls.index, cls.values, color=["#4C72B0", "#C44E52"])for i, v inenumerate(cls.values): axes[0].text(i, v, f"{v}\n{v/len(b3db)*100:.1f}%", ha="center", va="bottom")axes[0].set_title("Clases")axes[0].set_ylim(0, cls.max()*1.18)grp = b3db["group"].value_counts().sort_index()axes[1].bar(grp.index, grp.values, color="#55A868")for i, v inenumerate(grp.values): axes[1].text(i, v, str(v), ha="center", va="bottom")axes[1].set_title("Categorías B3DB (A–D)")axes[1].set_ylim(0, grp.max()*1.15)ct = pd.crosstab(b3db["group"], b3db["BBB+/BBB-"], normalize="index")*100ct.plot(kind="bar", stacked=True, ax=axes[2], color=["#4C72B0", "#C44E52"], legend=True)axes[2].set_title("Balance de clases dentro de cada grupo (%)")axes[2].set_xlabel(""); axes[2].set_ylabel("%")axes[2].legend(title="", loc="lower right")plt.tight_layout(); fig.savefig(DIR_FIGURAS /"fig-clases.png", dpi=180, bbox_inches="tight"); plt.show()print("razón de desbalance BBB+/BBB-: {:.2f} a 1".format(cls.max()/cls.min()))print("\nconteos por grupo y clase:")print(pd.crosstab(b3db["group"], b3db["BBB+/BBB-"], margins=True).to_string())print("\nFrecuencias de la categoría de incertidumbre de regresión:")print(b3db["b3db_uncertainty_regression"].value_counts(dropna=False).to_string())
razón de desbalance BBB+/BBB-: 1.74 a 1

conteos por grupo y clase:
BBB+/BBB-  BBB+  BBB-   All
group
A           930   128  1058
B          2486  1135  3621
C          1536  1539  3075
D             4    47    51
All        4956  2849  7805

Frecuencias de la categoría de incertidumbre de regresión:
b3db_uncertainty_regression
NaN    6753
B       659
A       241
D       149
C         3
3.1 Qué se observa en las categorías A–D y por qué no son una escala de calidad
B3DB indica que sus categorías agrupan registros según la incertidumbre de las mediciones, pero no publica el criterio completo de asignación. El diccionario de la patrocinadora advierte que filtrar “solo A” no tiene respaldo documentado. Los patrones siguientes describen estos datos; no establecen una escala ordinal de calidad ni una regla automática de exclusión:
Grupo
Qué distingue a sus registros
A
1,058 filas etiquetadas; 1,052 tienen logBB y 6 no
B
3,621 filas; todas tienen threshold = −1
C
3,075 filas; sin logBB ni umbral, mediana de 1 referencia
D
51 filas; sin logBB ni umbral, mediana de 3 referencias
La celda siguiente compara referencias y prevalencia de BBB− entre categorías. Las seis filas sin clase BBB integrada sí tienen logBB, pero no tienen categoría de clasificación group; por eso no entran en esta comparación. Según el diccionario de la patrocinadora, su clase de B3DB no se integró porque la fila de clasificación correspondía a otra forma estereoquímica y no coincidió en la unión por estructura.
Código
b3db["nref"] = b3db["reference"].fillna("").str.count(r"R\d")resumen = []for g in ["A", "B", "C", "D"]: s = b3db[b3db["group"] == g] resumen.append({"grupo": g, "n": len(s),"referencias (mediana)": s["nref"].median(),"referencias (mínimo)": s["nref"].min(),"% BBB−": round((s["BBB+/BBB-"] =="BBB-").mean() *100, 1), })print(pd.DataFrame(resumen).set_index("grupo").to_string())print(f"\n>> El grupo D tiene MÁS respaldo bibliográfico que el C "f"(mediana {b3db[b3db.group=='D'].nref.median():.0f} contra "f"{b3db[b3db.group=='C'].nref.median():.0f}).")conf = (b3db.groupby("inchikey_calc"if"inchikey_calc"in b3db else"Inchi")["BBB+/BBB-"] .nunique() >1).sum()print(f">> Compuestos con etiquetas contradictorias en todo el conjunto: {conf}")
          n  referencias (mediana)  referencias (mínimo)  % BBB−
grupo
A      1058                    5.0                     1    12.1
B      3621                    3.0                     1    31.3
C      3075                    1.0                     1    50.0
D        51                    3.0                     3    92.2

>> El grupo D tiene MÁS respaldo bibliográfico que el C (mediana 3 contra 1).
>> Compuestos con etiquetas contradictorias en todo el conjunto: 0
El grupo está correlacionado con la etiqueta
La proporción de BBB− varía notablemente entre categorías y el grupo D tiene una mediana de referencias mayor que C. Como B3DB no publica el criterio completo de asignación, estos patrones no demuestran que A–D ordenen la calidad. Filtrar por grupo altera la composición de clases y no tiene justificación como control de calidad.
Código
glob = (b3db["BBB+/BBB-"] =="BBB-").mean() *100ab = (b3db[b3db.group.isin(["A", "B"])]["BBB+/BBB-"] =="BBB-").mean() *100print(f"% BBB− en el conjunto completo : {glob:5.1f}%")print(f"% BBB− si se filtra a A+B : {ab:5.1f}%")print(f"\n>> Filtrar a A+B reduce en {glob-ab:.1f} puntos porcentuales la prevalencia BBB−,")print(">> alterando y agravando el desbalance; no demuestra que C o D sean etiquetas de menor calidad.")print("\nDecisión: la columna de grupo se usa como variable de ESTRATIFICACIÓN,")print("no como criterio de exclusión.")
% BBB− en el conjunto completo :  36.5%
% BBB− si se filtra a A+B      :  27.0%

>> Filtrar a A+B reduce en 9.5 puntos porcentuales la prevalencia BBB−,
>> alterando y agravando el desbalance; no demuestra que C o D sean etiquetas de menor calidad.

Decisión: la columna de grupo se usa como variable de ESTRATIFICACIÓN,
no como criterio de exclusión.
El balance de clases difiere entre A+B y C, por lo que los resultados deberán reportarse también por categoría o estrato cuando sea pertinente. Esa diferencia describe heterogeneidad del conjunto; por sí sola no demuestra que C contenga etiquetas de menor calidad ni justifica excluirlo.
4. Descriptores fisicoquímicos
Código
def descriptores(m):return {"TPSA": Descriptors.TPSA(m),"logP": Descriptors.MolLogP(m),"MW": Descriptors.MolWt(m),"HBD": rdMolDescriptors.CalcNumHBD(m),"HBA": rdMolDescriptors.CalcNumHBA(m),"RotB": rdMolDescriptors.CalcNumRotatableBonds(m),"Arom": rdMolDescriptors.CalcNumAromaticRings(m),"Fsp3": rdMolDescriptors.CalcFractionCSP3(m),"HeavyAtoms": m.GetNumHeavyAtoms(), }desc = pd.DataFrame([descriptores(m) for m in b3db["mol"]], index=b3db.index)b3db = pd.concat([b3db, desc], axis=1)b3db["y"] = (b3db["BBB+/BBB-"] =="BBB+").astype(int) # 1 = cruza# los 9 descriptores, no solo los 5 con mejor poder discriminante: conviene ver# la escala y dispersión de todos antes de decidir cuáles pasan al Avance 2.b3db[list(desc.columns) + ["y"]].groupby("y").describe().T.round(2).loc[ [(c, s) for c in desc.columns for s in ["mean","50%","std"]]]
y
0
1
TPSA
mean
133.74
60.02
50%
114.99
53.85
std
81.44
37.50
logP
mean
1.45
2.87
50%
1.46
2.92
std
2.75
1.58
MW
mean
464.22
339.85
50%
424.53
330.48
std
210.08
121.13
HBD
mean
3.37
1.23
50%
3.00
1.00
std
3.01
1.09
HBA
mean
7.59
3.97
50%
6.00
4.00
std
4.46
2.21
RotB
mean
6.25
3.92
50%
6.00
4.00
std
4.35
2.82
Arom
mean
1.40
1.27
50%
1.00
1.00
std
1.16
1.03
Fsp3
mean
0.50
0.50
50%
0.46
0.50
std
0.24
0.22
HeavyAtoms
mean
32.07
23.91
50%
29.00
23.00
std
14.96
8.54
4.0 Estadísticos descriptivos completos, asimetría y curtosis
La tabla anterior solo muestra media, mediana y desviación por clase. Aquí se resumen los nueve descriptores sobre el conjunto de trabajo completo, con cuartiles, extremos, asimetría (skew; 0 es simétrica, positiva es cola a la derecha) y curtosis en exceso (kurt; 0 es la de una normal, positiva es cola pesada). Son estadísticos descriptivos y no estiman nada sobre moléculas nuevas.
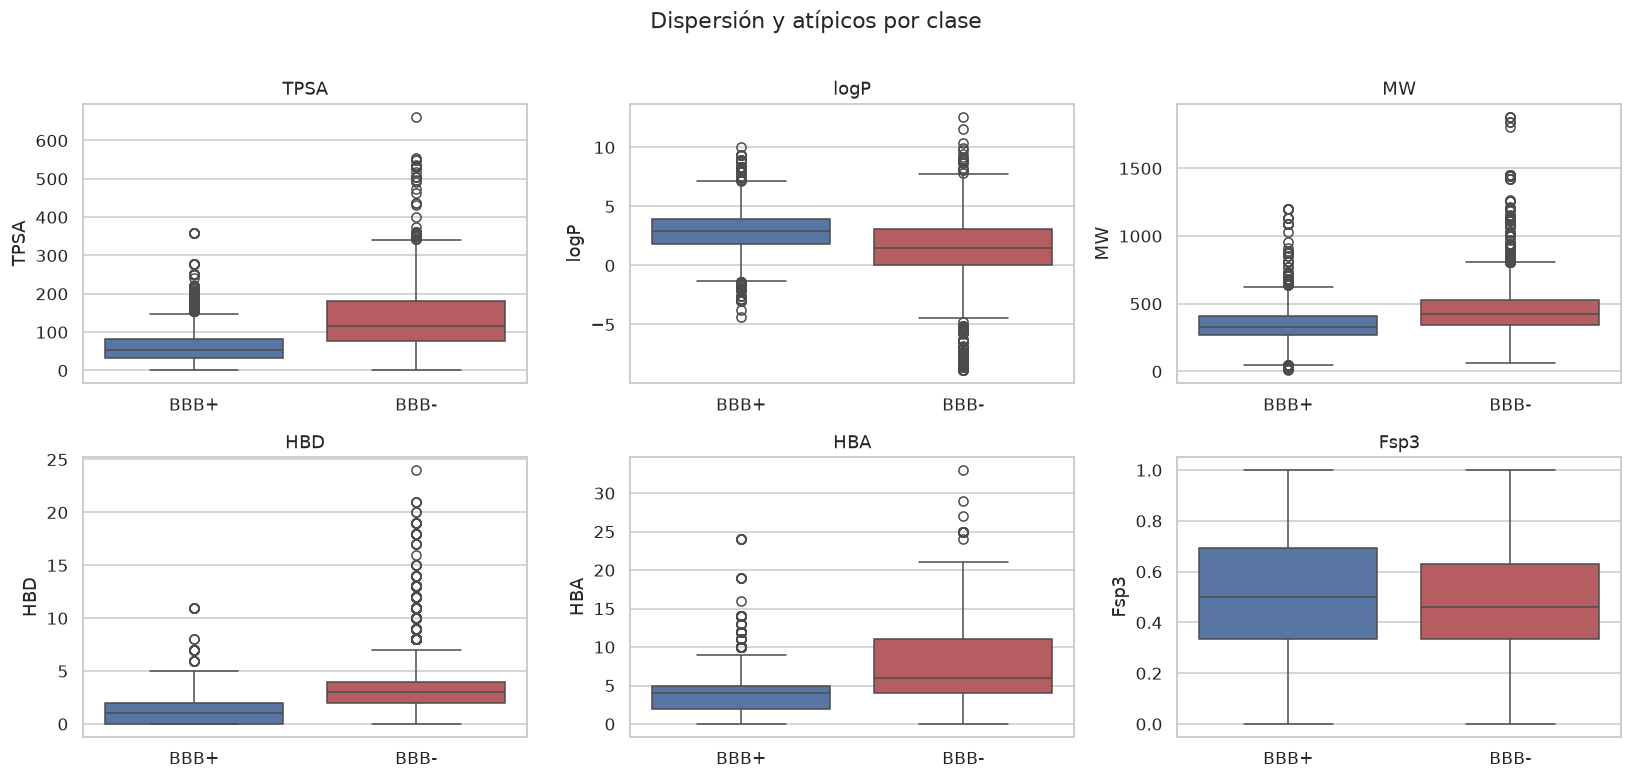
Lectura. Los nueve descriptores están completos (7,805 valores cada uno). Las escalas son muy distintas (MW llega a 1,882, Fsp3 no pasa de 1), lo que importa para los modelos sensibles a escala; cómo se trata se decide en el Avance 2. En TPSA, MW, HBD, RotB, HBA y HeavyAtoms la media supera a la mediana (por ejemplo TPSA 86.9 contra 72.6, HBD 2.0 contra 1.0): cola larga a la derecha, con curtosis en exceso alta (RotB 24.0, HBD 14.9, HeavyAtoms 10.2, MW 9.7). logP es la única con cola a la izquierda (asimetría −1.02; mínimo −8.9). Fsp3 está acotada en [0, 1] y es más plana que una normal (curtosis −0.46). Los extremos (TPSA 0, MW 6.9, HBD 24) son estructuras válidas, vistas en la §4.5.
Código
sk = r1["skew"]muy = sk[sk.abs() >2].sort_values(key=abs, ascending=False)mod = sk[(sk.abs() >1) & (sk.abs() <=2)].sort_values(key=abs, ascending=False)print("|skew| > 2 (muy asimétricas) :", {k: round(v, 2) for k, v in muy.items()} or"ninguna")print("1 < |skew| <= 2 (asimétricas) :", {k: round(v, 2) for k, v in mod.items()} or"ninguna")print("|skew| <= 1 (aprox. simétricas) :", {k: round(v, 2) for k, v in sk[sk.abs() <=1].items()} or"ninguna")
¿Existen distribuciones sesgadas? ¿Se necesita alguna transformación no lineal?Sí hay sesgo: cinco de los nueve descriptores son muy asimétricos (|asimetría| > 2: HBD 3.10, RotB 3.00, HeavyAtoms 2.16, MW 2.12, TPSA 2.08), dos más lo son moderadamente (1 < |asimetría| ≤ 2: HBA 1.69 y logP −1.02) y solo Arom (0.70) y Fsp3 (0.22) son aproximadamente simétricas. TPSA, MW y HeavyAtoms quedan apenas por encima de 2 y la asimetría es sensible a los pocos valores extremos (la regla de Tukey marca 5% de TPSA y MW), así que la frontera no debe leerse como exacta.
Si hace falta transformar no se decide aquí. Esta tabla describe el conjunto completo y elegir una transformación mirando la asimetría de todo el conjunto contaminaría la validación. La decisión se toma en el Avance 2 y se ajusta solo con los datos de entrenamiento (notebook 02_Feature_Eng, §8, Normalización); allí se comprueba además si cambia algo para el modelo, porque los modelos de árboles previstos son invariantes a transformaciones monótonas y los lineales o basados en distancia no.
Código
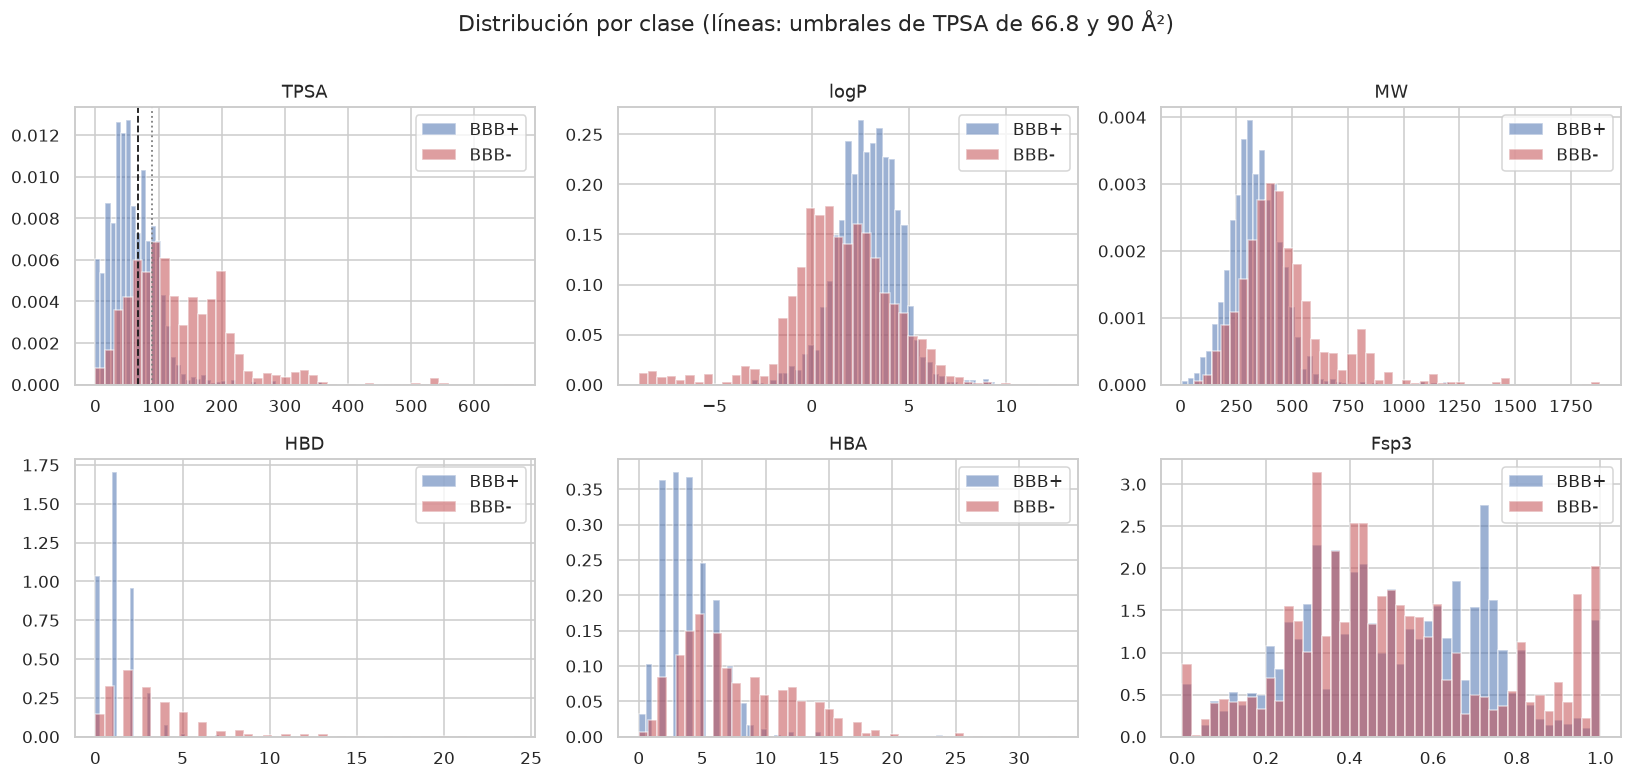
principales = ["TPSA","logP","MW","HBD","HBA","Fsp3"]fig, axes = plt.subplots(2, 3, figsize=(15, 7))for ax, col inzip(axes.ravel(), principales):for etiqueta, color in [("BBB+","#4C72B0"), ("BBB-","#C44E52")]: sub = b3db.loc[b3db["BBB+/BBB-"]==etiqueta, col] ax.hist(sub, bins=45, alpha=.55, label=etiqueta, color=color, density=True) ax.set_title(col); ax.legend()axes[0,0].axvline(66.8, ls="--", c="k", lw=1.2)axes[0,0].axvline(90, ls=":", c="gray", lw=1.2)axes[0,0].text(68, ax.get_ylim()[1]*.02, "", fontsize=8)plt.suptitle("Distribución por clase (líneas: umbrales de TPSA de 66.8 y 90 Ų)", y=1.01)plt.tight_layout(); fig.savefig(DIR_FIGURAS /"fig-descriptores.png", dpi=180, bbox_inches="tight"); plt.show()
4.1 Poder discriminante individual, medido en estos datos
La literatura reporta, sobre el subconjunto de 1,058 compuestos con logBB, que TPSA es el mejor predictor individual con AUC 0.746, seguido de HBD (0.699), HBA (0.673), logP (0.617) y peso molecular (0.583).
Aquí se recalcula sobre los dos conjuntos para comparar de forma honesta: el subconjunto comparable (grupo A, que es el que tiene logBB) y el conjunto completo.
Código
def aucs(df, etiqueta): filas = []for col in ["TPSA","logP","MW","HBD","HBA","Fsp3","RotB","Arom","HeavyAtoms"]: a = roc_auc_score(df["y"], df[col])# un descriptor puede discriminar en sentido inverso; se reporta el poder, no la dirección filas.append({"descriptor": col, "AUC": max(a, 1-a), "sentido": "+"if a>=.5else"−"})return (pd.DataFrame(filas).assign(conjunto=etiqueta) .sort_values("AUC", ascending=False))comp = pd.concat([ aucs(b3db[b3db["group"]=="A"], f"grupo A (n={(b3db['group']=='A').sum()})"), aucs(b3db[b3db["group"].isin(["A","B"])], f"A+B (n={b3db['group'].isin(['A','B']).sum()})"), aucs(b3db, f"completo (n={len(b3db)})"),])tabla = comp.pivot(index="descriptor", columns="conjunto", values="AUC").round(3)tabla["publicado (n=1058)"] = pd.Series({"TPSA":0.746,"HBD":0.699,"HBA":0.673,"logP":0.617,"MW":0.583})tabla.sort_values(tabla.columns[0], ascending=False)
conjunto
A+B (n=4679)
completo (n=7805)
grupo A (n=1058)
publicado (n=1058)
descriptor
TPSA
0.850
0.813
0.797
0.746
HBD
0.811
0.777
0.748
0.699
HBA
0.803
0.763
0.728
0.673
MW
0.729
0.703
0.612
0.583
logP
0.728
0.681
0.620
0.617
HeavyAtoms
0.709
0.683
0.599
NaN
RotB
0.683
0.695
0.627
NaN
Arom
0.501
0.525
0.582
NaN
Fsp3
0.501
0.516
0.526
NaN
4.2 Correlación entre descriptores
Los descriptores no son independientes entre sí: varios miden, con fórmulas distintas, un aspecto muy parecido de la molécula. Antes de decidir cuáles conservar como variables de entrada (Avance 2), conviene ver qué tan redundantes son entre sí, no solo qué tanto separan la clase.
Código
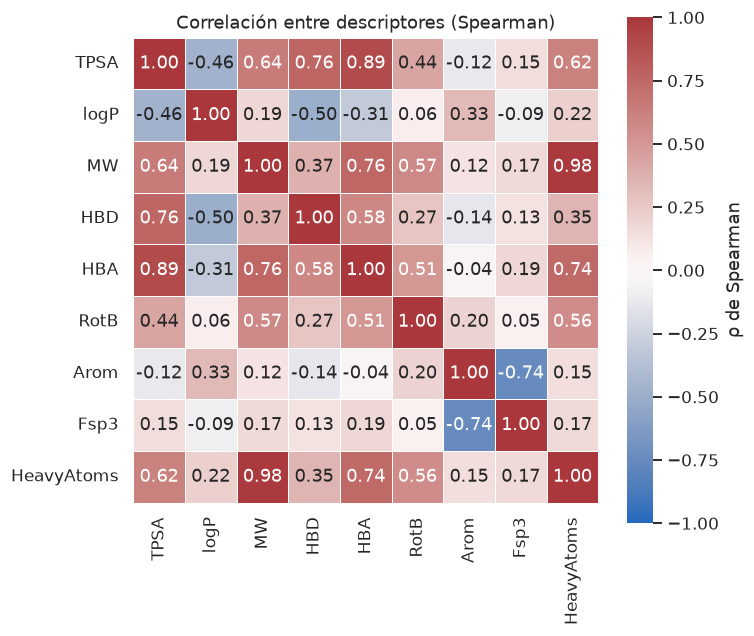
cols = ["TPSA","logP","MW","HBD","HBA","RotB","Arom","Fsp3","HeavyAtoms"]# Spearman, no Pearson: HBD/HBA/RotB/Arom son conteos enteros de distribución sesgada,# y Spearman capta relaciones monótonas sin asumir linealidad ni normalidad.corr = b3db[cols].corr(method="spearman")fig, ax = plt.subplots(figsize=(7, 6))sns.heatmap(corr, annot=True, fmt=".2f", cmap="vlag", center=0, vmin=-1, vmax=1, square=True, linewidths=.5, cbar_kws={"label": "ρ de Spearman"}, ax=ax)ax.set_title("Correlación entre descriptores (Spearman)")plt.tight_layout(); fig.savefig(DIR_FIGURAS /"fig-correlacion.png", dpi=180, bbox_inches="tight"); plt.show()pares = corr.where(~np.eye(len(cols), dtype=bool)).unstack().dropna()pares = pares[pares.index.map(lambda x: x[0] < x[1])].sort_values(key=abs, ascending=False)print("Pares con mayor correlación (valor absoluto):")print(pares.head(6).to_string())
MW y HeavyAtoms: ρ = 0.98. Son casi la misma variable medida dos veces —peso molecular y número de átomos pesados crecen juntos por construcción—, lo que explica que tengan un poder discriminante casi idéntico en la tabla anterior (0.729 contra 0.710 en A+B): no son dos señales independientes, sino una sola vista desde dos ángulos.
TPSA con HBA (ρ = 0.89) y con HBD (ρ = 0.76). Consistente con que el TPSA se calcula de forma aditiva sobre los mismos átomos polares que definen a los donadores y aceptores de puente de hidrógeno (sección 5.3 del marco teórico). Que los tres encabecen la tabla de poder discriminante no son tres hallazgos independientes: es un solo eje de polaridad medido de tres formas distintas.
Arom y Fsp3: ρ = −0.74. Tiene sentido químico directo: más anillos aromáticos implica una molécula más plana, con menos carbonos de hibridación sp3.
Consecuencia para el Avance 2. Al construir la matriz de características no conviene tratar estos descriptores como señales independientes; un método de selección (por ejemplo, un umbral de correlación o la importancia embebida de un modelo de árboles) debería descartar la redundancia entre MW y HeavyAtoms antes de entrenar, en vez de dejar que el modelo la absorba sin control.
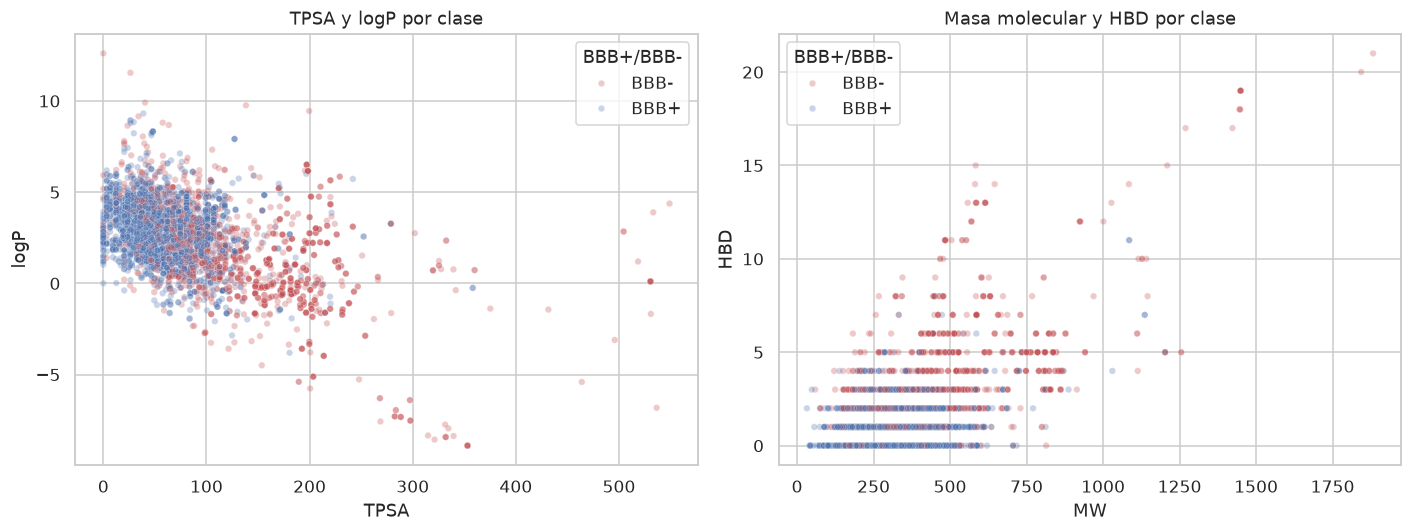
Relaciones bivariantes entre descriptores y clase
La correlación resume relaciones entre descriptores, pero no muestra su distribución conjunta con la etiqueta. Se grafican TPSA–logP y MW–HBD, coloreados por clase, usando una muestra aleatoria reproducible de hasta 4,000 observaciones para facilitar la lectura. Las estadísticas de correlación se calculan sobre el conjunto de trabajo completo.
La literatura sitúa el óptimo en 66.8 Ų, notablemente más estricto que el clásico de ~90. Aquí se rederiva con el estadístico J de Youden.
Estos umbrales son descriptivos, no umbrales de uso. Los valores de esta sección se derivan sobre todo el conjunto (o sobre cada subconjunto completo) con un solo fin: mostrar que el óptimo de TPSA se mueve con el subconjunto (grupo A, A+B, completo) y que por tanto no es una constante. Como se calculan con las mismas filas que después se evalúan, no estiman desempeño en moléculas nuevas. El umbral que usará el modelo se deriva solo con datos de entrenamiento (notebook 02_Feature_Eng, §4.1: 107 Ų). Para dimensionar cuánto del movimiento es solo incertidumbre de muestreo, la celda siguiente añade intervalos de confianza bootstrap.
Código
def umbral_optimo(df, col="TPSA"):# TPSA alto predice BBB-, así que se invierte el signo para la curva ROC fpr, tpr, thr = roc_curve(df["y"], -df[col]) j = tpr - fprreturn-thr[j.argmax()], roc_auc_score(df["y"], -df[col]), j.max()for etiqueta, sub in [("grupo A", b3db[b3db["group"]=="A"]), ("A+B", b3db[b3db["group"].isin(["A","B"])]), ("completo", b3db)]: t, a, j = umbral_optimo(sub)print(f"{etiqueta:>9} (n={len(sub):>5}) · TPSA óptimo = {t:6.1f} Ų · AUC = {a:.3f} · J = {j:.3f}")print("\npublicado sobre n=1058: TPSA óptimo = 66.8 Ų, AUC = 0.746")
# Intervalos bootstrap (percentil 95%) del umbral de Youden de TPSA, con la misma función umbral_optimo.N_BOOT =1000rng = np.random.default_rng(42) # semilla fijasubconjuntos = [("grupo A", b3db[b3db["group"] =="A"]), ("A+B", b3db[b3db["group"].isin(["A", "B"])]), ("completo", b3db)]intervalos = {}for etiqueta, sub in subconjuntos: puntual = umbral_optimo(sub)[0] boot = []for _ inrange(N_BOOT): rem = sub.iloc[rng.integers(0, len(sub), len(sub))] boot.append(umbral_optimo(rem)[0]) lo, hi = np.percentile(boot, [2.5, 97.5]) intervalos[etiqueta] = (lo, hi)print(f"{etiqueta:>9} (n={len(sub):>5}) · TPSA óptimo = {puntual:6.1f} Ų · IC95% bootstrap = [{lo:6.1f}, {hi:6.1f}] · mediana = {np.median(boot):6.1f}")nombres =list(intervalos)print()for i inrange(len(nombres)):for j inrange(i +1, len(nombres)): a, b = intervalos[nombres[i]], intervalos[nombres[j]] solapa =max(a[0], b[0]) <=min(a[1], b[1])print(f"{nombres[i]} vs {nombres[j]}: {'se solapan'if solapa else'NO se solapan'}")
  grupo A (n= 1058) · TPSA óptimo =   66.6 Ų · IC95% bootstrap = [  57.3,   83.6] · mediana =   66.6
      A+B (n= 4679) · TPSA óptimo =   83.6 Ų · IC95% bootstrap = [  81.5,   86.6] · mediana =   83.6
 completo (n= 7805) · TPSA óptimo =  101.9 Ų · IC95% bootstrap = [  81.5,  107.2] · mediana =   95.9

grupo A vs A+B: se solapan
grupo A vs completo: se solapan
A+B vs completo: se solapan
Lectura de los intervalos. Los tres intervalos se solapan por pares, pero eso no significa que los tres umbrales sean el mismo. (1) El del grupo A es ancho, [57.3, 83.6] Ų (26 Ų): con 1,058 compuestos el óptimo está mal determinado, y el valor publicado (66.8) cae dentro. (2) El de A+B es angosto, [81.5, 86.6] Ų (5 Ų), y deja fuera tanto el punto de A (66.6) como el del conjunto completo (101.9). (3) El del conjunto completo es ancho y asimétrico, [81.5, 107.2] Ų (26 Ų), con mediana bootstrap de 95.9, por debajo de su punto de 101.9: la curva de Youden es casi plana entre ~80 y ~107 Ų y el máximo salta dentro de esa zona. El solapamiento entre A y A+B es de apenas 2 Ų (81.5 a 83.6) y los subconjuntos están anidados, no son muestras independientes, por lo que la comparación por solapamiento es solo orientativa.
Conclusión. El umbral óptimo de TPSA depende del subconjunto y, dentro de cada uno, está poco determinado (de 5 a 26 Ų de ancho). No es una constante que se pueda fijar a partir de este EDA, lo que confirma que el valor que use el modelo debe derivarse solo con entrenamiento.
4.4 La regla de dos parámetros: TPSA < 67 Ų y HBD ≤ 1
La literatura reporta 96.6% de precisión para BBB+ y especificidad de 0.852 sobre el subconjunto con logBB. Se evalúa aquí, junto con las reglas compuestas clásicas para comparar.
Código
def evaluar(df, mascara, nombre): pred = mascara.astype(int) tp = ((pred==1) & (df["y"]==1)).sum(); fp = ((pred==1) & (df["y"]==0)).sum() tn = ((pred==0) & (df["y"]==0)).sum(); fn = ((pred==0) & (df["y"]==1)).sum() prec = tp/(tp+fp) if tp+fp else np.nanreturn {"regla": nombre, "precisión BBB+": prec, "sensibilidad": tp/(tp+fn),"especificidad": tn/(tn+fp), "cobertura": (tp+fp)/len(df),# la predicción es binaria: roc_auc_score daría exactamente la exactitud balanceada"exactitud balanceada": balanced_accuracy_score(df["y"], pred),"MCC": matthews_corrcoef(df["y"], pred),# AUPRC sobre la clase minoritaria (BBB−); con una predicción binaria es un único punto P–R"AUPRC BBB− (minoritaria)": average_precision_score(1- df["y"], 1- pred)}def tabla_reglas(df, etiqueta): r = [ evaluar(df, (df.TPSA <67) & (df.HBD <=1), "TPSA<67 y HBD≤1"), evaluar(df, df.TPSA <90, "TPSA<90 (clásica)"), evaluar(df, df.TPSA <67, "TPSA<67 sola"), evaluar(df, (df.MW<=500)&(df.logP<=5)&(df.HBD<=5)&(df.HBA<=10), "Lipinski (regla de 5)"), evaluar(df, (df.TPSA<=140)&(df.RotB<=10), "Veber"), ]return pd.DataFrame(r).assign(conjunto=etiqueta).round(3)pd.concat([tabla_reglas(b3db[b3db["group"]=="A"], "grupo A"), tabla_reglas(b3db, "completo")]).set_index(["conjunto","regla"])
precisión BBB+
sensibilidad
especificidad
cobertura
exactitud balanceada
MCC
AUPRC BBB− (minoritaria)
conjunto
regla
grupo A
TPSA<67 y HBD≤1
0.966
0.589
0.852
0.536
0.720
0.288
0.207
TPSA<90 (clásica)
0.923
0.882
0.469
0.839
0.675
0.311
0.230
TPSA<67 sola
0.953
0.718
0.742
0.663
0.730
0.318
0.229
Lipinski (regla de 5)
0.890
0.857
0.227
0.847
0.542
0.076
0.134
Veber
0.894
0.944
0.188
0.928
0.566
0.166
0.158
completo
TPSA<67 y HBD≤1
0.853
0.515
0.846
0.384
0.680
0.357
0.480
TPSA<90 (clásica)
0.806
0.790
0.669
0.623
0.729
0.455
0.553
TPSA<67 sola
0.837
0.610
0.793
0.463
0.701
0.389
0.503
Lipinski (regla de 5)
0.728
0.885
0.424
0.772
0.654
0.354
0.498
Veber
0.747
0.966
0.430
0.822
0.698
0.497
0.586
Cómo leer esta tabla. La precisión alta de una regla permisiva puede ser un artefacto del desbalance: si el 63.5% de los compuestos son BBB+, una regla que marque casi todo como positivo tendrá precisión cercana a 0.635 sin aportar nada. Por eso hay que leer precisión, especificidad y cobertura juntas, y por eso el AUPRC es más diagnóstico que el AUROC en conjuntos desbalanceados (capítulo 4.7 del marco teórico).
Por qué cambian las columnas de métricas. La columna que antes se llamaba «AUC» se calculaba como roc_auc_score(y, pred) con predbinaria (0/1). Con una predicción de dos valores la curva ROC tiene un único punto intermedio y ese área vale exactamente (sensibilidad + especificidad)/2: es la exactitud balanceada, no un AUROC, y se renombra así. El proyecto declaró MCC y AUPRC sobre la clase minoritaria (BBB−) como métricas de evaluación (decisión C.1 de docs/decisiones.md), porque ni la exactitud ni el AUROC reflejan bien un conjunto desbalanceado, así que se añaden aquí para comparar las reglas con la misma vara que se usará con los modelos. El MCC resume las cuatro celdas de la matriz de confusión en un número entre −1 y 1 (0 es azar).
Para una regla binaria el AUPRC degenera: solo hay un umbral posible, así que la curva de precisión–exhaustividad tiene un único punto, y average_precision_score(1 - y, 1 - pred) equivale a la precisión sobre BBB− multiplicada por la exhaustividad de BBB− en ese punto. Sirve para ordenar las reglas, no es comparable con el AUPRC de un modelo que entrega probabilidades. Lectura de la tabla: en el conjunto completo la regla de dos parámetros es la de mayor precisión BBB+ (0.853) pero tiene un MCC de 0.357, menor que el de TPSA<90 (0.455) y que el de Veber (0.497), que es la de peor especificidad (0.430) pero a cambio acierta casi todos los BBB+ (sensibilidad 0.966). Es decir, las métricas ordenan las reglas de forma distinta y la regla «más precisa» no es la mejor en MCC. En el grupo A las reglas basadas en TPSA quedan entre 0.29 y 0.32 de MCC, y Lipinski (0.076) y Veber (0.166) casi no mejoran el azar. El AUPRC de BBB− debe leerse contra la prevalencia de la clase minoritaria (12.1% en A, 36.5% en el conjunto completo), que es lo que obtendría una regla al azar: en A los valores van de 0.13 a 0.23 y en el completo de 0.48 a 0.59. Las reglas usan umbrales publicados sin ajustar a estos datos, pero se evalúan sobre las mismas filas; las cifras son descriptivas y no estiman desempeño en moléculas nuevas.
4.5 Valores atípicos: ¿ruido o diversidad real?
Las reglas anteriores usan los descriptores tal cual, sin recortar extremos. Antes de dar por buenas esas conclusiones conviene comprobar qué tan extremos son los valores y si contaminan lo ya medido.
print("Regla de Tukey (1.5×RIC) por descriptor:\n")filas = []for col in ["TPSA","logP","MW","HBD","HBA","RotB","Arom","Fsp3","HeavyAtoms"]: q1, q3 = b3db[col].quantile([.25, .75]) ric = q3 - q1 lo, hi = q1 -1.5*ric, q3 +1.5*ric n = ((b3db[col] < lo) | (b3db[col] > hi)).sum() filas.append({"descriptor": col, "atípicos": n, "%": round(n/len(b3db)*100, 1),"rango normal": f"[{lo:.1f}, {hi:.1f}]", "rango real": f"[{b3db[col].min():.1f}, {b3db[col].max():.1f}]"})pd.DataFrame(filas)
Regla de Tukey (1.5×RIC) por descriptor:
descriptor
atípicos
%
rango normal
rango real
0
TPSA
404
5.2
[-57.4, 206.3]
[0.0, 662.4]
1
logP
216
2.8
[-2.7, 7.7]
[-8.9, 12.6]
2
MW
389
5.0
[36.0, 700.9]
[6.9, 1882.3]
3
HBD
297
3.8
[-2.0, 6.0]
[0.0, 24.0]
4
HBA
783
10.0
[-1.5, 10.5]
[0.0, 33.0]
5
RotB
178
2.3
[-4.0, 12.0]
[0.0, 53.0]
6
Arom
13
0.2
[-3.0, 5.0]
[0.0, 8.0]
7
Fsp3
0
0.0
[-0.2, 1.2]
[0.0, 1.0]
8
HeavyAtoms
441
5.7
[3.5, 47.5]
[1.0, 136.0]
¿Son errores? No: ya pasaron el filtro de validez de SMILES (sección 2.2), así que son estructuras químicamente válidas, no basura de parseo. Revisando quiénes son:
Código
print("Compuestos más pesados (MW):")print(b3db.nlargest(5, "MW")[["compound_name","MW","BBB+/BBB-"]].to_string(index=False))print("\nCompuestos más ligeros (MW):")print(b3db.nsmallest(5, "MW")[["compound_name","MW","BBB+/BBB-"]].to_string(index=False))print("\nCompuestos más lipofílicos (logP):")print(b3db.nlargest(5, "logP")[["compound_name","logP","BBB+/BBB-"]].to_string(index=False))
Compuestos más pesados (MW):
     compound_name       MW BBB+/BBB-
valinegramicidin a 1882.332      BBB-
               NaN 1882.332      BBB-
       teichomycin 1879.680      BBB-
               NaN 1843.295      BBB-
      gramicidin-b 1843.295      BBB-

Compuestos más ligeros (MW):
compound_name     MW BBB+/BBB-
    7439-93-2  6.941      BBB+
      methane 16.043      BBB+
        water 18.015      BBB+
    7440-01-9 20.180      BBB+
     nitrogen 28.014      BBB+

Compuestos más lipofílicos (logP):
        compound_name    logP BBB+/BBB-
        beta-carotene 12.6058      BBB-
    retinol palmitate 11.5425      BBB-
          xanthophyll 10.4033      BBB-
pipotiazine palmitate 10.0563      BBB+
             probucol  9.9083      BBB-
En el extremo superior de MW aparecen antibióticos glicopeptídicos (teichomycin, gramicidina): moléculas grandes y polares, reales, y —consistente con la regla fisicoquímica— casi todas BBB−. En el extremo inferior están gases y elementos (metano, agua, nitrógeno, litio, neón), BBB+ porque su tamaño mínimo les permite difundir sin restricción. En el extremo de logP aparecen carotenoides y ésteres de retinol, compuestos naturales muy lipofílicos que, según la sección 5.3 del marco teórico, quedan atrapados en la membrana en vez de cruzarla limpiamente.
Decisión: no se recortan ni transforman en esta etapa. Tres razones: (1) son estructuras válidas, no errores de parseo; (2) los modelos de árboles previstos no requieren normalizar los descriptores, aunque su efecto se comprobará durante la validación; y (3) recortarlos podría sesgar el conjunto contra productos naturales grandes o lipofílicos, que son relevantes para el proyecto. La conservación no supone que todo extremo sea inocuo: se inspeccionan los casos y se evaluará su influencia sin decidir transformaciones con datos de prueba.
Nota metodológica sobre HBA. La regla de Tukey marca 10% de HBA como atípico, la proporción más alta de la tabla. HBA es un conteo entero con distribución sesgada a la derecha —la mayoría de los compuestos tiene pocos aceptores—, y esa regla es más agresiva en variables así: no es evidencia de más error, solo de más asimetría.
5. Productos naturales y el resto: tres orígenes, no dos
Este análisis solo es posible con el conjunto de la patrocinadora: el cruce con COCONUT identifica qué compuestos tienen equivalente en el catálogo de productos naturales. Importa porque es el objetivo del proyecto: los compuestos que se quieren priorizar son productos naturales, así que conviene saber si se comportan como el resto del conjunto.
El cruce no da dos grupos sino tres, y el diccionario de la patrocinadora los distingue con dos columnas:
Origen
Cómo se define
Columna
Natural exacto
la estructura completa, con estereoquímica, está en COCONUT
coconut_id_exact_match presente
Análogo estereoquímico
el esqueleto de conectividad está en COCONUT, pero no esa forma estereoquímica
solo coconut_ids_key14_match presente
Sin equivalente natural
ni la estructura ni su esqueleto están en COCONUT
las dos ausentes
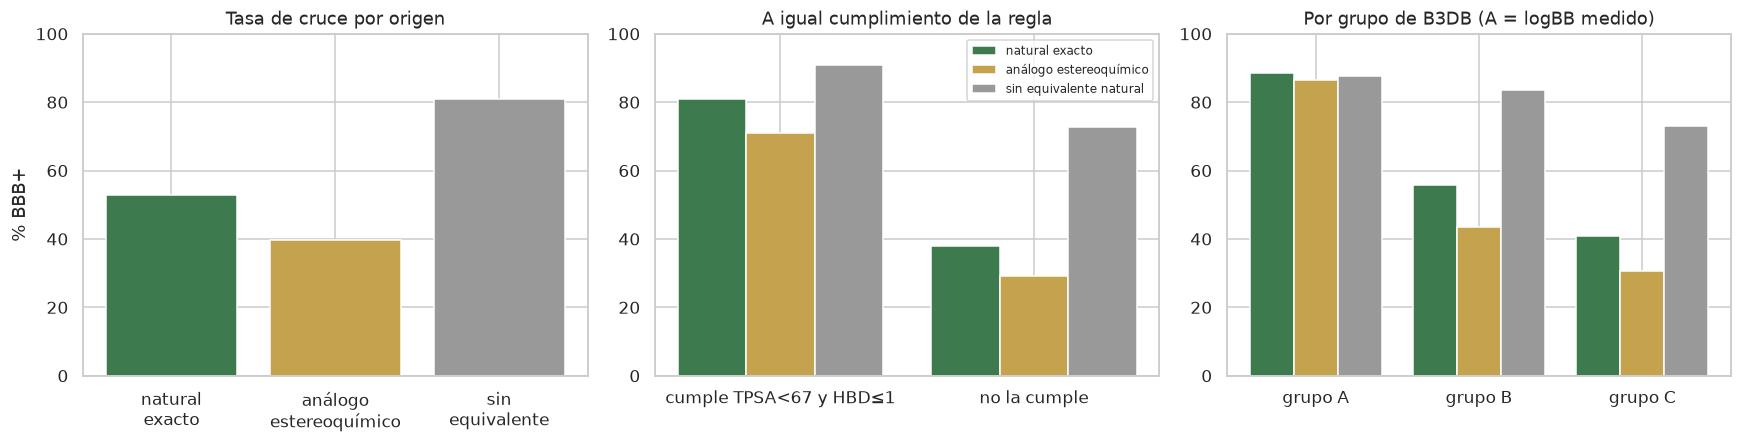
Versión anterior, y por qué se cambió. La primera versión de esta sección comparaba los naturales exactos contra un único grupo llamado «Sintético» que juntaba los análogos y los compuestos sin equivalente. Ese grupo no es sintético: más de una quinta parte son estereoisómeros de un producto natural. Con dos grupos la diferencia era de 18.9 puntos (52.7% contra 71.7% BBB+); separando los tres orígenes resulta otra cosa, y la celda siguiente la muestra junto a la versión agregada para que se vea de dónde salía el 18.9.
Código
con = b3db[b3db["BBB+/BBB-"].notna()].copy()exacto = con["coconut_id_exact_match"].notna()esqueleto = con["coconut_ids_key14_match"].notna()ORIGENES = ["natural exacto", "análogo estereoquímico", "sin equivalente natural"]con["origen"] = np.select([exacto, esqueleto &~exacto], ORIGENES[:2], default=ORIGENES[2])con["bbbp"] = (con["BBB+/BBB-"] =="BBB+").astype(int)b3db["natural"] = b3db["coconut_id_exact_match"].notna() # la definición que usan los Avances 2 y 3def wilson(k, n, z=1.96):"""Intervalo de confianza del 95% para una proporción (Wilson).""" p = k / n centro = (p + z**2/ (2* n)) / (1+ z**2/ n) radio = z * np.sqrt(p * (1- p) / n + z**2/ (4* n**2)) / (1+ z**2/ n)return centro - radio, centro + radiofilas = []for o in ORIGENES: g = con[con["origen"] == o] lo, hi = wilson(g["bbbp"].sum(), len(g)) filas.append({"origen": o, "n": len(g), "% BBB+": round(g["bbbp"].mean() *100, 1),"IC 95%": f"[{lo*100:.1f}, {hi*100:.1f}]"})tres = pd.DataFrame(filas).set_index("origen")print("Tasa de cruce por origen (7,805 compuestos con clase):")print(tres.to_string())resto = con[con["origen"] !="natural exacto"]tasa_nat = con.loc[con["origen"] =="natural exacto", "bbbp"].mean() *100tasa_sin_eq = con.loc[con["origen"] == ORIGENES[2], "bbbp"].mean() *100print(f"\nVersión agregada anterior: natural exacto {tasa_nat:.1f}% "f"contra «resto» {resto['bbbp'].mean()*100:.1f}% (n = {len(resto):,}),")print(f" una diferencia de {resto['bbbp'].mean()*100- tasa_nat:.1f} puntos. "f"El «resto» mezcla {(resto['origen'] == ORIGENES[1]).sum():,} análogos ({tres.loc[ORIGENES[1], '% BBB+']}%) "f"con {(resto['origen'] == ORIGENES[2]).sum():,} sin equivalente ({tres.loc[ORIGENES[2], '% BBB+']}%).")print(f"\n>> Contra los compuestos sin equivalente natural la diferencia es de "f"{tasa_sin_eq - tasa_nat:.1f} puntos,")print(f">> y los análogos cruzan todavía menos que los naturales exactos.")
Tasa de cruce por origen (7,805 compuestos con clase):
                            n  % BBB+        IC 95%
origen
natural exacto           3366    52.7  [51.0, 54.4]
análogo estereoquímico   1003    39.7  [36.7, 42.7]
sin equivalente natural  3436    81.0  [79.6, 82.3]

Versión agregada anterior: natural exacto 52.7% contra «resto» 71.7% (n = 4,439),
  una diferencia de 18.9 puntos. El «resto» mezcla 1,003 análogos (39.7%) con 3,436 sin equivalente (81.0%).

>> Contra los compuestos sin equivalente natural la diferencia es de 28.3 puntos,
>> y los análogos cruzan todavía menos que los naturales exactos.
5.1 ¿Hay explicación química, o es la forma de etiquetar?
Una diferencia de este tamaño no conviene darla por entendida. Hay dos lecturas que se pueden poner a prueba con estos datos:
Química: si los naturales son más polares, las reglas fisicoquímicas conocidas la explicarían. Lo que se mide no es si la proporción que cumple la regla difiere entre orígenes —eso son dos diferencias de proporciones que no se descomponen una en otra (issue #85)— sino si a igual cumplimiento de la regla los orígenes siguen cruzando distinto.
Procedencia de la etiqueta: el grupo A de B3DB tiene logBB medido y los grupos B y C vienen de clasificaciones publicadas. Si la brecha solo aparece donde la etiqueta no es una medición, podría reflejar cómo se etiquetó y no solo la química.
Código
# la regla de dos parámetros con el valor PUBLICADO (67 Ų), no uno derivado aquí:# la derivación de este notebook (§4.3) da 66.6 / 83.6 / 101.9 Ų según el subconjuntocon["favorable"] = (con["TPSA"] <67) & (con["HBD"] <=1)print("Mediana de cada descriptor por origen:")print(con.groupby("origen")[["TPSA", "HBD", "HBA", "MW", "logP", "Fsp3"]].median().round(2) .reindex(ORIGENES).to_string())print("\n% que cumple TPSA < 67 Ų y HBD ≤ 1:")print((con.groupby("origen")["favorable"].mean() *100).round(1).reindex(ORIGENES).to_string())# a igual cumplimiento de la regla: si la química (esta regla) explicara la brecha,# dentro de cada estrato los orígenes cruzarían parecidoestr = (con.groupby(["favorable", "origen"])["bbbp"].agg(n="size", tasa="mean") .assign(tasa=lambda t: (t["tasa"] *100).round(1)))print("\n% BBB+ a igual cumplimiento de la regla:")print(estr["tasa"].unstack().reindex(columns=ORIGENES) .rename(index={True: "cumple la regla", False: "no la cumple"}).to_string())print("\nn por estrato:")print(estr["n"].unstack().reindex(columns=ORIGENES) .rename(index={True: "cumple la regla", False: "no la cumple"}).to_string())# por grupo de B3DB: A tiene logBB medido; B y C, clasificación publicadapor_grupo = (con.groupby(["group", "origen"])["bbbp"].agg(n="size", tasa="mean") .assign(tasa=lambda t: (t["tasa"] *100).round(1)))print("\n% BBB+ por grupo de B3DB y origen (n entre paréntesis):")tab = por_grupo["tasa"].unstack().reindex(columns=ORIGENES)nn = por_grupo["n"].unstack().reindex(columns=ORIGENES)print(tab.astype(str).radd("").add(" (").add(nn.astype("Int64").astype(str)).add(")").to_string())
Mediana de cada descriptor por origen:
                          TPSA  HBD  HBA      MW  logP  Fsp3
origen
natural exacto           78.36  2.0  5.0  359.40  2.13  0.50
análogo estereoquímico   97.74  2.0  6.0  404.42  2.22  0.54
sin equivalente natural  62.24  1.0  4.0  357.35  2.97  0.45

% que cumple TPSA < 67 Ų y HBD ≤ 1:
origen
natural exacto             34.6
análogo estereoquímico     25.0
sin equivalente natural    45.9

% BBB+ a igual cumplimiento de la regla:
origen           natural exacto  análogo estereoquímico  sin equivalente natural
favorable
no la cumple               37.8                    29.3                     72.6
cumple la regla            80.9                    70.9                     90.9

n por estrato:
origen           natural exacto  análogo estereoquímico  sin equivalente natural
favorable
no la cumple               2201                     752                     1858
cumple la regla            1165                     251                     1578

% BBB+ por grupo de B3DB y origen (n entre paréntesis):
origen natural exacto análogo estereoquímico sin equivalente natural
group
A          88.4 (414)              86.6 (82)              87.7 (562)
B         55.9 (1455)             43.5 (345)             83.6 (1821)
C         40.9 (1451)             30.7 (574)             73.0 (1050)
D            6.5 (46)               50.0 (2)                 0.0 (3)
Código
fig, axes = plt.subplots(1, 3, figsize=(16, 4.2))colores = {"natural exacto": "#3D7A4E", "análogo estereoquímico": "#C4A24E", "sin equivalente natural": "#999999"}t = tres["% BBB+"]axes[0].bar(range(3), t.values, color=[colores[o] for o in t.index])axes[0].set_xticks(range(3)); axes[0].set_xticklabels(["natural\nexacto", "análogo\nestereoquímico", "sin\nequivalente"])axes[0].set_ylabel("% BBB+"); axes[0].set_title("Tasa de cruce por origen"); axes[0].set_ylim(0, 100)ancho =0.27for k, o inenumerate(ORIGENES): vals = [estr.loc[(f, o), "tasa"] for f in (True, False)] axes[1].bar(np.arange(2) + (k -1) * ancho, vals, ancho, color=colores[o], label=o)axes[1].set_xticks(range(2)); axes[1].set_xticklabels(["cumple TPSA<67 y HBD≤1", "no la cumple"])axes[1].set_title("A igual cumplimiento de la regla"); axes[1].set_ylim(0, 100); axes[1].legend(fontsize=8)grupos = [g for g in ["A", "B", "C"] if g in tab.index]for k, o inenumerate(ORIGENES): axes[2].bar(np.arange(len(grupos)) + (k -1) * ancho, tab.loc[grupos, o].values, ancho, color=colores[o])axes[2].set_xticks(range(len(grupos))); axes[2].set_xticklabels([f"grupo {g}"for g in grupos])axes[2].set_title("Por grupo de B3DB (A = logBB medido)"); axes[2].set_ylim(0, 100)# nombre propio: fig-naturales.png es la del reporte del Avance 1 ya entregado, que no se reescribeplt.tight_layout(); fig.savefig(DIR_FIGURAS /"fig-naturales-tres-origenes.png", dpi=180, bbox_inches="tight"); plt.show()
Lectura. Tres resultados, cada uno con su cifra en la salida de arriba:
La brecha es mayor de lo que decía la versión agregada. Los compuestos sin equivalente natural cruzan en 81.0% y los naturales exactos en 52.7%: 28.3 puntos, no 18.9. Los análogos estereoquímicos cruzan todavía menos (39.7%), así que no se pueden juntar con los compuestos sin equivalente como si fueran «sintéticos». Los intervalos de Wilson no se solapan entre ninguno de los tres orígenes.
La regla TPSA/HBD no explica la brecha. Los naturales la cumplen menos, pero a igual cumplimiento siguen cruzando menos: entre los que cumplen la regla, 80.9% contra 90.9%; entre los que no, 37.8% contra 72.6%. Si la regla explicara la diferencia, dentro de cada estrato las tasas serían parecidas.
Donde la etiqueta es una medición, la brecha desaparece. En el grupo A, que tiene logBB medido, los tres orígenes cruzan igual (88.4%, 86.6% y 87.7%); la brecha aparece en B y C, que vienen de clasificaciones publicadas. Esto no prueba la causa —el grupo A es pequeño y no es una muestra al azar—, pero es compatible con que parte de la brecha venga de cómo se etiquetó y no solo de la química.
Qué implica. Las tres observaciones son descriptivas y no establecen causalidad. Lo que sí fijan es cómo hay que reportar: el desempeño del modelo se reporta por origen —con las tres categorías, declarando cuál se usa— y dentro de cada grupo A, B y C, porque es esa evaluación la que puede distinguir entre aprender química y aprender cómo se etiquetó (decisión 1.6 del registro). Los Avances 2 y 3 usan natural = coincidencia exacta con COCONUT; la categoría de análogos queda disponible para el análisis por origen.
5. Diversidad estructural y viabilidad del scaffold split
Código
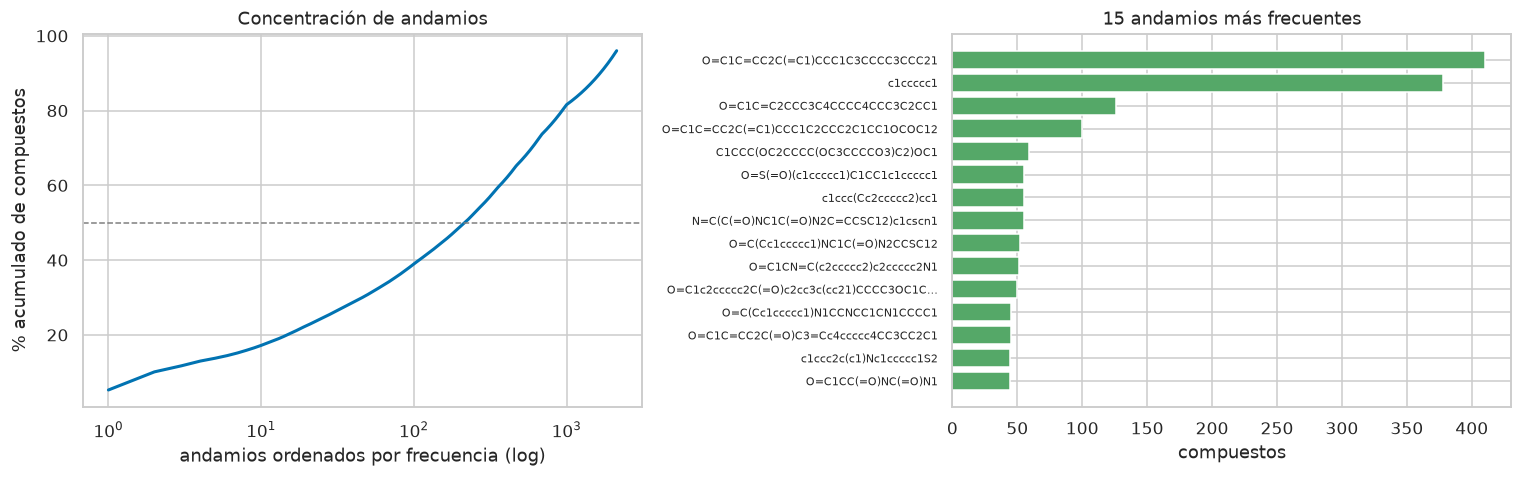
def andamio(m):try:return MurckoScaffold.MurckoScaffoldSmiles(mol=m)exceptException:returnNoneb3db["andamio"] = [andamio(m) for m in b3db["mol"]]sin_andamio = b3db["andamio"].isna().sum() + (b3db["andamio"]=="").sum()conteo = b3db.loc[b3db["andamio"].notna() & (b3db["andamio"]!=""), "andamio"].value_counts()print(f"compuestos sin andamio (acíclicos): {sin_andamio}")print(f"andamios de Murcko distintos: {len(conteo)}")print(f"andamios únicos (aparecen 1 vez): {(conteo==1).sum()} ({(conteo==1).sum()/len(conteo)*100:.1f}%)")print(f"compuestos en andamios únicos: {(conteo==1).sum()} ({(conteo==1).sum()/len(b3db)*100:.1f}% del total)")print(f"\nrazón compuestos/andamio: {(len(b3db)-sin_andamio)/len(conteo):.2f}"f" (= ({len(b3db)} − {sin_andamio} acíclicos) / {len(conteo)} andamios; los acíclicos no tienen andamio)")acum = conteo.cumsum()/len(b3db)*100for n in [10, 32, 100, 500]:if n <=len(conteo):print(f"los {n:>3} andamios más frecuentes cubren el {acum.iloc[n-1]:5.1f}% de los compuestos")
compuestos sin andamio (acíclicos): 312
andamios de Murcko distintos: 2126
andamios únicos (aparecen 1 vez): 1131  (53.2%)
compuestos en andamios únicos: 1131 (14.5% del total)

razón compuestos/andamio: 3.52  (= (7805 − 312 acíclicos) / 2126 andamios; los acíclicos no tienen andamio)
los  10 andamios más frecuentes cubren el  17.2% de los compuestos
los  32 andamios más frecuentes cubren el  26.6% de los compuestos
los 100 andamios más frecuentes cubren el  39.0% de los compuestos
los 500 andamios más frecuentes cubren el  66.5% de los compuestos
Código
fig, axes = plt.subplots(1, 2, figsize=(14, 4.5))axes[0].plot(range(1, len(conteo)+1), acum.values, lw=2)axes[0].axhline(50, ls="--", c="gray", lw=1)axes[0].set_xscale("log")axes[0].set_xlabel("andamios ordenados por frecuencia (log)")axes[0].set_ylabel("% acumulado de compuestos")axes[0].set_title("Concentración de andamios")top = conteo.head(15)axes[1].barh(range(len(top)), top.values, color="#55A868")axes[1].set_yticks(range(len(top)))axes[1].set_yticklabels([s[:38] + ("…"iflen(s)>38else"") for s in top.index], fontsize=7)axes[1].invert_yaxis()axes[1].set_title("15 andamios más frecuentes")axes[1].set_xlabel("compuestos")plt.tight_layout(); plt.show()
5.1 Lectura para el scaffold split
Un scaffold split agrupa por andamio y reparte grupos completos entre entrenamiento y prueba, de modo que ninguna estructura del entrenamiento reaparezca en la prueba. Dos condiciones lo hacen viable:
Muchos andamios distintos, para que los grupos sean pequeños y el reparto quede balanceado.
Ningún andamio dominante, porque uno que concentre buena parte del conjunto forzaría un split desbalanceado.
Una proporción alta de andamios que aparecen una sola vez es buena señal: significa diversidad estructural real.
Código
# ¿el balance de clases se mantiene dentro de los andamios grandes?grandes = conteo.head(10).indexres = []for s in grandes: sub = b3db[b3db["andamio"]==s] res.append({"andamio": s[:45], "n": len(sub), "% BBB+": (sub["y"].mean()*100).round(1)})pd.DataFrame(res)
andamio
n
% BBB+
0
O=C1C=CC2C(=C1)CCC1C3CCCC3CCC21
410
99.5
1
c1ccccc1
378
66.1
2
O=C1C=C2CCC3C4CCCC4CCC3C2CC1
126
78.6
3
O=C1C=CC2C(=C1)CCC1C2CCC2C1CC1OCOC12
100
99.0
4
C1CCC(OC2CCCC(OC3CCCCO3)C2)OC1
59
0.0
5
O=S(=O)(c1ccccc1)C1CC1c1ccccc1
55
52.7
6
c1ccc(Cc2ccccc2)cc1
55
81.8
7
N=C(C(=O)NC1C(=O)N2C=CCSC12)c1cscn1
55
5.5
8
O=C(Cc1ccccc1)NC1C(=O)N2CCSC12
52
0.0
9
O=C1CN=C(c2ccccc2)c2ccccc2N1
51
100.0
6. El conjunto de validación externa
Código
sv = pd.read_csv(EXT /"spielvogel2025"/"bbb_penetration_database.csv", sep=";")print(f"Spielvogel et al. 2025: {len(sv)} compuestos · {len(sv.columns)} columnas\n")print(sv["CNS positivity"].value_counts().to_string())print("\n¿trae estructura?", [c for c in sv.columns ifany(k in c.lower() for k in ("smi","inchi","cid"))] or"NO — solo nombres y descriptores precalculados")print("\nprimeros nombres:", list(sv["Compound"].head(5)))
Spielvogel et al. 2025: 154 compuestos · 26 columnas

CNS positivity
positive    68
efflux      44
negative    42

¿trae estructura? NO — solo nombres y descriptores precalculados

primeros nombres: ['Sitagliptin', 'Teicoplanin', 'Fluoroethyl-Carfentanilhydrochloride', 'SCH-23388hydrochloride', 'SCH-23390hydrochloride']
Limitación confirmada. El conjunto no trae SMILES ni InChI: son el nombre del compuesto y 25 descriptores precalculados. Para usarlo con este pipeline hay que resolver los 154 nombres a estructura, por ejemplo vía PubChem, y revisar a mano los que no resuelvan limpiamente — entradas como Fluoroethyl-Carfentanilhydrochloride son propensas a fallar.
Su valor justifica el trabajo: separa los sustratos de eflujo como clase propia en vez de forzar una etiqueta binaria, que es exactamente la ambigüedad por concentración que señalaron los asesores.
Como los descriptores precalculados usan software distinto (ACD), se comparan con los calculados por RDKit sobre B3DB para ver si son conmensurables.
Código
comunes = {"MW":" MW (g/mol)", "TPSA":"tPSA", "logP":"logP"}print("comparación de rangos, B3DB (RDKit) contra Spielvogel (ACD/precalculado):\n")for rd, ac in comunes.items():if ac in sv.columns: a = pd.to_numeric(sv[ac], errors="coerce").dropna()print(f"{rd:>5} B3DB: media {b3db[rd].mean():7.1f} rango [{b3db[rd].min():.1f}, {b3db[rd].max():.1f}]")print(f"{'':>5} SV : media {a.mean():7.1f} rango [{a.min():.1f}, {a.max():.1f}] (n={len(a)})")
comparación de rangos, B3DB (RDKit) contra Spielvogel (ACD/precalculado):

   MW  B3DB: media   385.3  rango [6.9, 1882.3]
       SV  : media   434.6  rango [142.2, 1879.7]  (n=154)
 TPSA  B3DB: media    86.9  rango [0.0, 662.4]
       SV  : media    85.3  rango [3.2, 662.0]  (n=154)
 logP  B3DB: media     2.4  rango [-8.9, 12.6]
       SV  : media     3.0  rango [-3.2, 9.1]  (n=136)
7. Conclusiones del Avance 1
El análisis del conjunto curado por la patrocinadora proporciona una base trazable para estudiar la permeabilidad de la barrera hematoencefálica. De las 7,811 filas, 7,805 tienen etiqueta BBB; las otras seis contienen logBB, pero la clase de B3DB no se integró porque, según el diccionario de la patrocinadora, la fila de clasificación correspondía a otra forma estereoquímica y no coincidió en la unión por estructura. Se excluyen del análisis de clasificación sin imputarles clase a partir de la conectividad. Los SMILES curados son parseables. El suplemento de agosto de 2025 (175 compuestos) no está integrado en el archivo y no se incorpora en esta fase (limitación, §2.1). La deduplicación por InChIKey completo identifica tres filas redundantes, y el agrupamiento por conectividad da 4,018 esqueletos únicos. Además, 131 esqueletos (429 registros) tienen etiquetas distintas entre estereoisómeros. Por ello, el número de filas no equivale al de unidades químicas independientes y la evaluación debe controlar la dependencia estructural.
La proporción global BBB+ es 63.5%, pero las frecuencias difieren entre las categorías A–D. B3DB no publica el criterio completo de asignación y estos datos no justifican interpretarlas como una escala de calidad ni descartar categorías. D tiene una mediana de tres referencias frente a una en C; no se hallaron etiquetas contradictorias entre duplicados exactos, aunque sí entre estereoisómeros con conectividad compartida. group debe conservarse para describir y estratificar análisis de sensibilidad, no como filtro automático ni como medida de confiabilidad.
TPSA, HBD y HBA presentan las AUC univariantes más altas en A+B (0.850, 0.811 y 0.803), pero sus correlaciones indican señales parcialmente redundantes (TPSA–HBA, ρ = 0.89; TPSA–HBD, ρ = 0.76; MW–HeavyAtoms, ρ = 0.98). Las AUC y los umbrales se calcularon sobre los mismos datos explorados: describen este conjunto, pero no estiman el desempeño en moléculas nuevas ni demuestran causalidad. La variación de los umbrales de TPSA entre subconjuntos impide tratarlos como una constante biológica universal: los intervalos bootstrap (1,000 remuestras) son [57.3, 83.6] Ų en el grupo A, [81.5, 86.6] en A+B y [81.5, 107.2] en el conjunto completo; se solapan por pares, pero son anchos (de 5 a 26 Ų) y los puntos de A y del conjunto completo quedan fuera del intervalo de A+B. Son umbrales descriptivos; el que usará el modelo se deriva solo con entrenamiento.
El cruce con COCONUT separa tres orígenes: naturales exactos (52.7% BBB+), análogos que solo comparten el esqueleto con un natural (39.7%) y compuestos sin equivalente natural (81.0%). La versión anterior juntaba los dos últimos como «sintéticos» y reportaba 18.9 puntos de diferencia; contra los compuestos sin equivalente son 28.3. La regla de TPSA y HBD no explica la brecha: a igual cumplimiento de la regla, los naturales siguen cruzando menos (80.9% contra 90.9% entre los que la cumplen; 37.8% contra 72.6% entre los que no). Y en el grupo A, el único con logBB medido, los tres orígenes cruzan igual (88.4%, 86.6% y 87.7%): la brecha aparece donde la etiqueta viene de una clasificación publicada. Su causa sigue abierta —curación de la etiqueta, eflujo activo o propiedades no medidas—, y por eso las evaluaciones futuras deben informar el desempeño por origen y dentro de cada grupo A–C, además del resultado global.
La diversidad de andamios y los casos de pureza de clase extrema respaldan una partición agrupada por estructura, no una división aleatoria de filas; los 312 compuestos acíclicos requieren una regla de asignación reproducible. Los valores señalados por Tukey se conservan como alertas de inspección, no se eliminan por definición. Cinco de los nueve descriptores tienen |asimetría| > 2 (HBD, RotB, HeavyAtoms, MW y TPSA) y dos más superan 1 (HBA y logP); y si transformarlos se decide en el Avance 2 y solo con datos de entrenamiento. El conjunto externo de Spielvogel todavía carece de SMILES e InChI, por lo que requiere resolver identidades y armonizar variables antes de permitir una evaluación estructural comparable.
En conjunto, este EDA identifica asociaciones fisicoquímicas y problemas de identidad, dependencia estructural y heterogeneidad que deben guiar el modelado; todavía no demuestra rendimiento predictivo ni causalidad. La siguiente etapa deberá mantener juntas las estructuras relacionadas, seleccionar variables y ajustar umbrales solo dentro del entrenamiento, y evaluar con métricas complementarias (incluidas MCC y AUPRC) y resultados separados por origen. Si las asociaciones no se sostienen en compuestos no vistos, la ausencia de un patrón generalizable deberá reportarse honestamente.
7.8 Siguientes pasos
Avance 2 (02_Feature_Eng.ipynb):
Calcular descriptores RDKit y huellas Morgan/ECFP4 de 2048 bits mediante rdFingerprintGenerator.
Diseñar la partición agrupada por estructura/andamio, evitando que estructuras relacionadas queden en particiones distintas y definiendo cómo asignar compuestos acíclicos.
Evaluar la redundancia de descriptores y mantener las categorías A–D para estratificación y análisis de sensibilidad, no para excluir datos.
Tareas de datos pendientes:
Resolver los 154 nombres del conjunto de Spielvogel a estructuras verificables.
Revisar los 131 esqueletos con etiquetas discordantes entre estereoisómeros.
Comunicar a B3DB la inconsistencia nombre/estructura detectada en las descargas de contraste, sin atribuir ese problema al archivo curado de la patrocinadora.