Bioactive AI · Equipo 7 · Maestría en Inteligencia Artificial Aplicada (TC5035.10)
El Avance 1 exploró el conjunto de permeabilidad, que es la etapa 1. Este notebook hace lo mismo con el conjunto de actividad sobre dianas del sistema nervioso central, que alimenta la etapa 2.
La pregunta que responde la etapa 2 es: para un compuesto que llega al cerebro, ¿tiene actividad sobre alguna diana asociada a neuroprotección, y sobre cuál?
Qué se busca aquí
Cuántos compuestos hay de verdad, no cuántas filas.
Si las dos etapas se pueden encadenar: cuántos compuestos tienen medición en ambos conjuntos.
Cómo convertir mediciones en etiquetas, que es la decisión más delicada del proyecto: la misma molécula es activa o inactiva según la concentración a la que se ensayó.
Los datos son los que entregó la patrocinadora el 25 de septiembre, con su diccionario de columnas.
1. Preparación
Código
import sys, warningsfrom pathlib import Pathimport numpy as npimport pandas as pdimport matplotlib.pyplot as pltfrom rdkit import Chem, RDLoggerwarnings.filterwarnings("ignore")RDLogger.DisableLog("rdApp.*")plt.rcParams.update({"figure.dpi": 110, "font.size": 9})pd.set_option("display.width", 160)RAIZ = Path.cwd().parent if Path.cwd().name =="notebooks"else Path.cwd()PROF = RAIZ /"data"/"external"/"profesora"print("RDKit", Chem.rdBase.rdkitVersion)
RDKit 2026.03.6
2. Estructura de los datos
El archivo reúne registros de tres fuentes y por dos rutas de selección distintas, y esa distinción condiciona todo lo que sigue.
Código
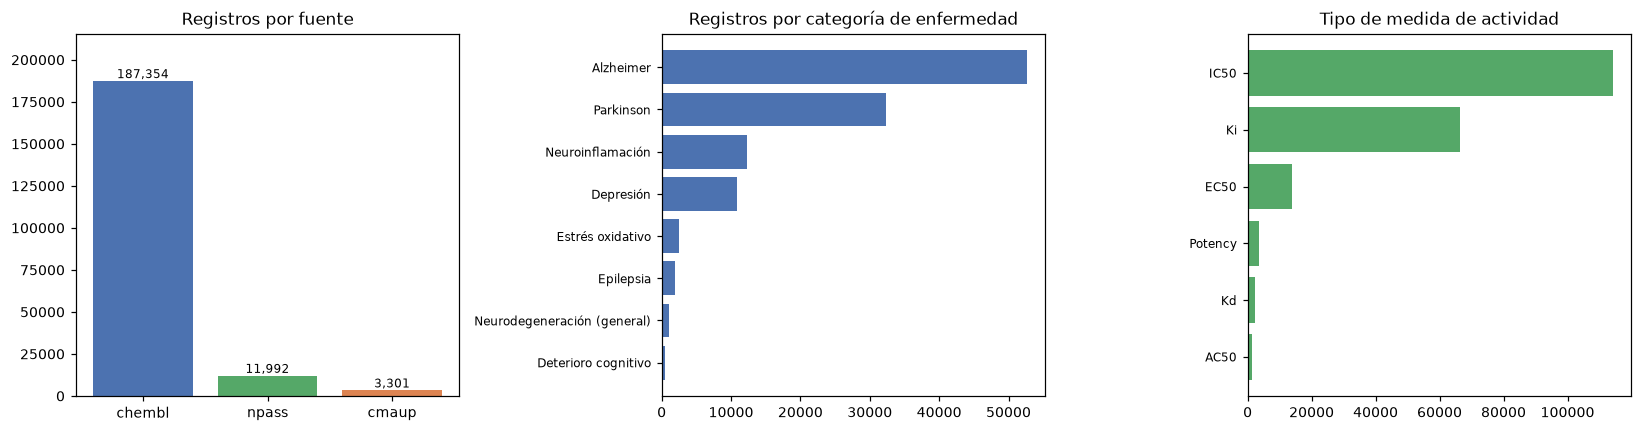
ACT = PROF /"snc_activity_crudo_v3_final_2026-09-25_Entrenamiento.csv"d = pd.read_csv(ACT, low_memory=False)d.columns = [c.strip().lstrip("\ufeff") for c in d.columns]print(f"{len(d):,} registros x {d.shape[1]} columnas\n")print("fuentes:")print(d["source"].value_counts().to_string())print("\nrutas de selección:")print(d["selection_route"].value_counts().to_string())
202,647 registros x 40 columnas

fuentes:
source
chembl    187354
npass      11992
cmaup       3301

rutas de selección:
selection_route
cns_target        108640
neuronal_assay     93204
both                 803
cns_target son registros de actividad contra una diana concreta de la lista del proyecto. neuronal_assay son ensayos sobre sistemas celulares neuronales sin una diana molecular identificada: miden un fenotipo, no una interacción. Son dos tipos de evidencia distintos y conviene no mezclarlos sin decirlo.
Código
# las columnas con huecos grandes, que es donde están las decisionesfaltantes = (1- d.notna().mean()).sort_values(ascending=False) *100tabla = faltantes[faltantes >0].to_frame("% faltante").round(1)tabla["distintos"] = [d[c].nunique() for c in tabla.index]print(tabla.to_string())
La misma lección del Avance 1: el número de filas sobreestima la información independiente.
Código
print(f"registros : {len(d):,}")print(f"source_compound_id : {d['source_compound_id'].nunique():,}")print(f"SMILES distintos : {d['smiles_raw'].nunique():,}")por_comp = d.groupby("source_compound_id").size()print(f"\nregistros por compuesto: mediana {por_comp.median():.0f}, "f"media {por_comp.mean():.1f}, máximo {por_comp.max():,}")print(f"compuestos con un solo registro: {(por_comp==1).sum():,} ({(por_comp==1).mean()*100:.1f}%)")
registros            : 202,647
source_compound_id   : 108,458
SMILES distintos     : 108,076

registros por compuesto: mediana 1, media 1.9, máximo 606
compuestos con un solo registro: 73,820 (68.1%)
Código
# se recalcula la identidad química desde el SMILES, igual que en la etapa 1unicos = d["smiles_raw"].dropna().unique()mols = {s: Chem.MolFromSmiles(s) for s in unicos}invalidos = [s for s, m in mols.items() if m isNone]ik = {s: Chem.MolToInchiKey(m) for s, m in mols.items() if m isnotNone}esq = {s: k[:14] for s, k in ik.items()}print(f"SMILES únicos : {len(unicos):,}")print(f" no parsean en RDKit : {len(invalidos):,} ({100*len(invalidos)/len(unicos):.2f}%)")print(f"InChIKey completos : {len(set(ik.values())):,}")print(f"esqueletos de conectividad: {len(set(esq.values())):,}")print(f"\n>> el tamaño efectivo es {len(set(esq.values())):,} estructuras, no {len(d):,} filas")
SMILES únicos          : 108,076
  no parsean en RDKit  : 8 (0.01%)
InChIKey completos     : 105,583
esqueletos de conectividad: 99,585

>> el tamaño efectivo es 99,585 estructuras, no 202,647 filas
Los 8 SMILES que no parsean son irrelevantes en proporción (0.01%), pero se descartan igual: una estructura que RDKit no puede leer tampoco puede generar descriptores.
La caída de 108,076 SMILES a 99,585 esqueletos es menos drástica que en la etapa 1 —ahí 7,805 filas eran 4,018 estructuras—, porque este conjunto tiene muchos más compuestos distintos y menos estereoisómeros repetidos.
4. ¿Se pueden encadenar las dos etapas?
Esta es la pregunta de diseño más importante del notebook. El pipeline supone que un compuesto pasa por la etapa 1 y después por la etapa 2. Para validar esa cadena de principio a fin hacen falta compuestos con medición en ambos conjuntos.
Código
b = pd.read_csv(PROF /"bbb_permeability_experimental.csv")b.columns = [c.strip().lstrip("\ufeff") for c in b.columns]esq_bbb =set(b["key14"].dropna())esq_act =set(esq.values())comun = esq_bbb & esq_actprint(f"esqueletos en el conjunto de permeabilidad : {len(esq_bbb):,}")print(f"esqueletos en el conjunto de actividad : {len(esq_act):,}")print(f"en AMBOS : {len(comun):,}")print(f"\n = {100*len(comun)/len(esq_act):.1f}% de los de actividad")print(f" = {100*len(comun)/len(esq_bbb):.1f}% de los de permeabilidad")
esqueletos en el conjunto de permeabilidad : 4,019
esqueletos en el conjunto de actividad     : 99,585
en AMBOS                                   : 1,033

  = 1.0% de los de actividad
  = 25.7% de los de permeabilidad
Solo 1,033 estructuras tienen medición en los dos conjuntos. Es el 1.0% del conjunto de actividad.
Tres consecuencias directas:
La cadena completa no se puede validar experimentalmente salvo en ese 1%. Para los otros 98,552 compuestos con actividad medida, la permeabilidad tendría que ser predicha por el modelo de la etapa 1, con toda la incertidumbre que eso arrastra.
Refuerza que la etapa 1 no opere como filtro duro. Descartar compuestos con un BBB− predicho —no medido— eliminaría candidatos con actividad real documentada por una predicción que nadie verificó.
Los 1,033 compuestos comunes son un activo: son el único conjunto donde se puede medir si la cadena de dos etapas funciona. Conviene reservarlos como conjunto de evaluación del sistema completo, no gastarlos en entrenamiento.
Código
# ¿qué aspecto tienen esos 1,033?s2e = pd.Series(esq)d["esqueleto"] = d["smiles_raw"].map(s2e)en_ambos = d[d["esqueleto"].isin(comun)]print(f"registros de actividad de esos compuestos: {len(en_ambos):,}")print("\nsu clase de permeabilidad:")print(b[b["key14"].isin(comun)]["bbb_class"].value_counts().to_string())print("\nsus fuentes de actividad:")print(en_ambos["source"].value_counts().to_string())
registros de actividad de esos compuestos: 30,016

su clase de permeabilidad:
bbb_class
BBB+    1249
BBB-     834

sus fuentes de actividad:
source
chembl    24301
npass      4222
cmaup      1493
5. Las dianas
La patrocinadora entregó una lista de 39 dianas con su gen, su categoría de enfermedad, el mecanismo y el efecto que se busca.
Código
dianas = pd.read_csv(PROF /"etiquetas_dianas_2026-09-25.csv")dianas.columns = [c.strip().lstrip("\ufeff") for c in dianas.columns]print(f"{len(dianas)} dianas definidas por la patrocinadora\n")print(dianas.groupby("diana_categoria").size().sort_values(ascending=False).to_string())
con_diana = d[d["diana_categoria"] !="Sin diana de la lista"]sin_diana = d[d["diana_categoria"] =="Sin diana de la lista"]print(f"registros CON diana de la lista : {len(con_diana):,} ({100*len(con_diana)/len(d):.1f}%) · "f"{con_diana['source_compound_id'].nunique():,} compuestos")print(f"registros SIN diana de la lista : {len(sin_diana):,} ({100*len(sin_diana)/len(d):.1f}%) · "f"{sin_diana['source_compound_id'].nunique():,} compuestos")print(f"\nlos 'sin diana' entraron todos por: {dict(sin_diana['selection_route'].value_counts())}")print("\ndistribución por enfermedad (solo los que tienen diana):")print(con_diana["diana_categoria"].value_counts().to_string())
registros CON diana de la lista : 114,549 (56.5%) · 69,887 compuestos
registros SIN diana de la lista : 88,098 (43.5%) · 42,799 compuestos

los 'sin diana' entraron todos por: {'neuronal_assay': np.int64(88098)}

distribución por enfermedad (solo los que tienen diana):
diana_categoria
Alzheimer                      52676
Parkinson                      32372
Neuroinflamación               12331
Depresión                      10888
Estrés oxidativo                2456
Epilepsia                       1862
Neurodegeneración (general)     1110
Deterioro cognitivo              488
Ansiedad                         160
Huntington                       153
ELA                               53
El 43.5% de los registros no corresponde a ninguna diana de la lista. No son basura: entraron por la ruta neuronal_assay, es decir, son ensayos sobre células neuronales donde se midió un efecto sin identificar la proteína responsable.
Es evidencia fenotípica, y sirve para otra pregunta —¿este compuesto hace algo en un sistema neuronal?— pero no para la que plantea la etapa 2, que es predecir actividad sobre una diana concreta. Mezclarlas produciría un modelo que no sabe qué está prediciendo.
Población inicial y límites actuales: 114,549 registros tienen una categoría de diana, pero solo 109,264 reciben etiqueta por alguna de las tres vías. Al agrupar por esqueleto de conectividad y gen objetivo, 4,810 registros etiquetados carecen de gen y 327 no tienen un esqueleto calculable; quedan 104,127 registros agrupables en 71,145 pares. Estos conteos describen una cohorte candidata, no el conjunto de entrenamiento definitivo: quedan pendientes la política para pares con etiquetas discordantes y la partición de los datos. Los 88,098 registros fenotípicos sin diana de la lista se conservan aparte para una pregunta distinta; no se descartan.
Código
fig, axes = plt.subplots(1, 3, figsize=(15, 4))v = d["source"].value_counts()axes[0].bar(range(len(v)), v.values, color=["#4C72B0","#55A868","#DD8452"])axes[0].set_xticks(range(len(v))); axes[0].set_xticklabels(v.index)for i, x inenumerate(v.values): axes[0].text(i, x, f"{x:,}", ha="center", va="bottom", fontsize=8)axes[0].set_title("Registros por fuente"); axes[0].set_ylim(0, v.max()*1.15)c = con_diana["diana_categoria"].value_counts().head(8)[::-1]axes[1].barh(range(len(c)), c.values, color="#4C72B0")axes[1].set_yticks(range(len(c))); axes[1].set_yticklabels(c.index, fontsize=8)axes[1].set_title("Registros por categoría de enfermedad")t = d["activity_type"].value_counts().head(6)[::-1]axes[2].barh(range(len(t)), t.values, color="#55A868")axes[2].set_yticks(range(len(t))); axes[2].set_yticklabels(t.index, fontsize=8)axes[2].set_title("Tipo de medida de actividad")plt.tight_layout(); plt.show()
6. El problema del etiquetado
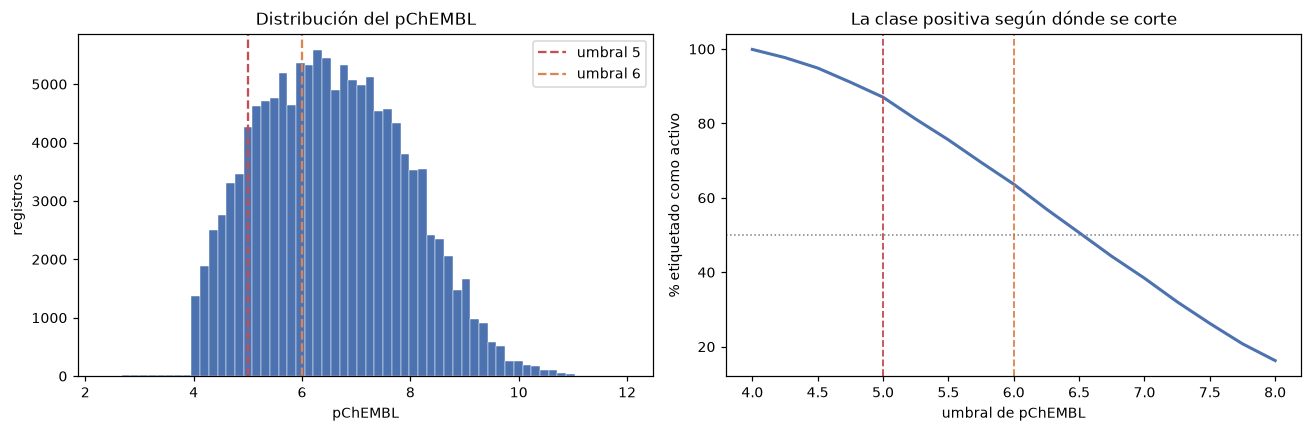
Aquí está una de las decisiones metodológicas más delicadas del proyecto. El criterio vigente propone pChEMBL ≥ 5 como umbral primario y ≥ 6 como análisis de robustez. Al aplicarlo sobre estos datos aparecen tres problemas que el criterio por sí solo no resuelve; la propuesta sigue pendiente de ratificación de la patrocinadora.
6.1 El pChEMBL solo existe para una de las tres fuentes
Código
print(d.groupby("source")["chembl_pchembl_value"] .agg(registros="size", con_pchembl="count") .assign(**{"% con pChEMBL": lambda x: (100*x.con_pchembl/x.registros).round(1)}) .to_string())nat = d["source"].isin(["npass", "cmaup"])print(f"\nregistros de NPASS y CMAUP (productos naturales): {nat.sum():,}")print(f"compuestos distintos en esas fuentes : {d.loc[nat,'source_compound_id'].nunique():,}")print(f"de ellos, con pChEMBL : {d.loc[nat,'chembl_pchembl_value'].notna().sum():,}")
        registros  con_pchembl  % con pChEMBL
source
chembl     187354       129243           69.0
cmaup        3301            0            0.0
npass       11992            0            0.0

registros de NPASS y CMAUP (productos naturales): 15,293
compuestos distintos en esas fuentes            : 4,482
de ellos, con pChEMBL                           : 0
Ninguno de los 15,293 registros de NPASS y CMAUP trae pChEMBL. El pChEMBL es un campo que calcula ChEMBL; las otras dos bases no lo publican.
Esto importa mucho más de lo que parece. NPASS y CMAUP son bases de productos naturales, y los productos naturales son justamente los compuestos que el proyecto quiere priorizar. Etiquetar solo con pChEMBL deja fuera, en silencio, a los 4,482 compuestos naturales del conjunto.
Es el mismo patrón que apareció en el Avance 1 con las categorías A–D: un criterio que parece técnico y neutro resulta estar correlacionado con justo lo que se quiere estudiar.
Una medida de >= 10000 nM no dice cuánto vale la actividad: dice que no se detectó efecto hasta esa concentración. Es información real —y casi siempre significa inactivo— pero no es un número con el que se pueda calcular un pChEMBL.
Y en efecto: ninguno de los 54,498 registros censurados trae pChEMBL. Filtrar por pChEMBL no solo descarta los productos naturales, también descarta la mayor parte de la evidencia de inactividad.
6.3 Hay 29,730 inactivos que solo existen como texto
Código
print(d.groupby(["evidence_kind", "relation_origin"]).size().to_string())print("\ncomentarios más frecuentes en los 'inactivo_por_texto':")print(d.loc[d.evidence_kind =="inactivo_por_texto", "chembl_activity_comment"] .dropna().value_counts().head(3).to_string())
evidence_kind       relation_origin
concentracion       fuente             170916
                    inferida             2001
inactivo_por_texto  texto_chembl        29730

comentarios más frecuentes en los 'inactivo_por_texto':
chembl_activity_comment
Inhibition < 50% @ 10 uM and thus dose-reponse curve not measured    29730
Son registros donde el artículo original dice algo como «Inhibition < 50% @ 10 uM»: el compuesto se ensayó, no funcionó, y nadie midió una curva dosis-respuesta. La curación de la patrocinadora los rescató como inactivos explícitos.
Son la mejor fuente de negativos del conjunto, y también quedan fuera si se etiqueta solo con pChEMBL.
6.4 El umbral cambia el problema, no solo la frontera
Código
e = d[d["chembl_pchembl_value"].notna()]filas = []for u in [4, 5, 6, 7]: act = e["chembl_pchembl_value"] >= u filas.append({"umbral": f"pChEMBL >= {u}", "activos": act.sum(), "inactivos": (~act).sum(),"% activos": round(100*act.mean(), 1),"razón": f"{act.sum()/max((~act).sum(),1):.1f}:1"})print(pd.DataFrame(filas).to_string(index=False))print(f"\n(sobre los {len(e):,} registros que tienen pChEMBL)")
fig, axes = plt.subplots(1, 2, figsize=(12, 4))axes[0].hist(e["chembl_pchembl_value"].dropna(), bins=60, color="#4C72B0", edgecolor="white", linewidth=.3)for u, col in [(5, "#C44E52"), (6, "#DD8452")]: axes[0].axvline(u, color=col, ls="--", lw=1.5, label=f"umbral {u}")axes[0].set_xlabel("pChEMBL"); axes[0].set_ylabel("registros")axes[0].set_title("Distribución del pChEMBL"); axes[0].legend()us = np.arange(4, 8.01, 0.25)pct = [100*(e["chembl_pchembl_value"] >= u).mean() for u in us]axes[1].plot(us, pct, color="#4C72B0", lw=2)for u, col in [(5, "#C44E52"), (6, "#DD8452")]: axes[1].axvline(u, color=col, ls="--", lw=1.2)axes[1].axhline(50, color="gray", ls=":", lw=1)axes[1].set_xlabel("umbral de pChEMBL"); axes[1].set_ylabel("% etiquetado como activo")axes[1].set_title("La clase positiva según dónde se corte")plt.tight_layout(); plt.show()
La distribución del pChEMBL está centrada en 6.5, así que los dos umbrales candidatos caen en plena masa de los datos, no en una cola:
pChEMBL ≥ 5 deja el 87.1% de activos: un desbalance de 6.7 a 1 donde la clase difícil es la inactiva.
pChEMBL ≥ 6 deja el 63.7%: un desbalance de 1.8 a 1, mucho más tratable.
No hay un mínimo natural en la distribución que sugiera dónde cortar. El umbral es una decisión del proyecto, no un hecho de los datos, y el Avance 1 ya mostró con el TPSA lo que pasa cuando un umbral derivado de un subconjunto se presenta como constante.
6.5 El balance con las tres vías, según la unidad de análisis
La tabla anterior se calcula solo sobre los registros que tienen pChEMBL, así que no describe el balance de todas las observaciones que podrían etiquetarse. Aquí se reportan dos unidades distintas: registros etiquetados de todo el archivo y pares únicos de estructura de conectividad × gen objetivo. La segunda es una agrupación exploratoria que colapsa estereoisómeros; no es un andamio Bemis–Murcko ni el conjunto final de entrenamiento.
Se definen tres:
Vía A — pChEMBL. Donde exista.
Vía B — concentración exacta. Registros sin pChEMBL pero con relación = y un valor convertible a nanomolar. Es la que recupera los productos naturales.
Vía C — inactivo declarado. Los inactivo_por_texto más los censurados cuyo corte es suficientemente alto para ser informativo.
Para este recuento, la vía C usa provisionalmente un límite censurado ≥ 10,000 nM. La sección anterior justifica ese valor por su frecuencia y por coincidir con la concentración de los inactivos textuales; sigue siendo una propuesta del equipo pendiente de ratificación y se debe comparar con el corte de 1,000 nM.
Código
FACTOR = {"nM":1, "uM":1e3, "um":1e3, "mM":1e6, "M":1e9, "pM":1e-3,"10^3nM":1e3, "10^2 uM":1e5, "10^6uM":1e9, "umol/L":1e3}d["nM"] = [v*FACTOR[u] if u in FACTOR else np.nanfor v, u inzip(d["activity_value_used"], d["activity_units_used"])]cen = d[d["activity_relation_used"].isin([">", ">=", ">>"])]print("Dónde cortar la censura: un '> X nM' solo informa si X es alto.\n")print("valores de corte más frecuentes (nM):")print(cen["nM"].value_counts().head(4).to_string())print(f"\nmediana del corte: {cen['nM'].median():,.0f} nM")for c in [1_000, 5_000, 10_000]: n = (cen["nM"] < c).sum()print(f" si se exige corte >= {c:>6,} nM, se descartan {n:,} censurados ({100*n/len(cen):.1f}%)")
Dónde cortar la censura: un '> X nM' solo informa si X es alto.

valores de corte más frecuentes (nM):
nM
10000.0     36653
100000.0     5105
1000.0       2954
30000.0      1678

mediana del corte: 10,000 nM
  si se exige corte >=  1,000 nM, se descartan 1,018 censurados (1.9%)
  si se exige corte >=  5,000 nM, se descartan 5,089 censurados (9.3%)
  si se exige corte >= 10,000 nM, se descartan 5,897 censurados (10.8%)
El corte natural es 10,000 nM, es decir 10 µM. Es el valor modal —36,653 de los 54,498 censurados— y la mediana. Y coincide con el texto de los inactivos declarados, que dicen literalmente «Inhibition < 50% @ 10 uM»: es la concentración estándar de cribado.
Regla: un registro censurado cuenta como inactivo cuando su corte es ≥ 10 µM. Por debajo se descarta por no informativo, lo que cuesta 5,897 registros, el 10.8% de los censurados.
Código
via_a = d["chembl_pchembl_value"].notna()via_b = (~via_a) & (d["activity_relation_used"] =="=") & d["nM"].notna()via_c = (~via_a) & ((d["evidence_kind"] =="inactivo_por_texto") | (d["activity_relation_used"].isin([">", ">=", ">>"]) & (d["nM"] >=10_000)))print("cobertura de cada vía:")for n, v in [("A · pChEMBL", via_a), ("B · concentración exacta", via_b), ("C · inactivo declarado", via_c)]:print(f" {n:26}{v.sum():>7,}")print(f" {'sin vía (se descartan)':26}{len(d) - (via_a | via_b | via_c).sum():>7,}")print("\ndesbalance resultante, con las tres vías aplicadas:")filas = []for u, nm in [(5, 10_000), (6, 1_000)]: act = (via_a & (d["chembl_pchembl_value"] >= u)) | (via_b & (d["nM"] <= nm)) ina = (via_a & (d["chembl_pchembl_value"] < u)) | (via_b & (d["nM"] > nm)) | via_c filas.append({"umbral": f"pChEMBL >= {u} (= {nm:,.0f} nM)", "activos": act.sum(), "inactivos": ina.sum(),"% activos": round(100*act.sum()/(act.sum()+ina.sum()), 1),"razón": f"{act.sum()/ina.sum():.1f}:1"})print(pd.DataFrame(filas).to_string(index=False))print("\nrecuento por par único de esqueleto de conectividad × gen objetivo (target_gene):")for u, nm in [(5, 10_000), (6, 1_000)]: act = (via_a & (d["chembl_pchembl_value"] >= u)) | (via_b & (d["nM"] <= nm)) ina = (via_a & (d["chembl_pchembl_value"] < u)) | (via_b & (d["nM"] > nm)) | via_c etiquetados_diana = con_diana.loc[(act | ina)[con_diana.index]].copy() etiquetados_diana["activo"] = act.loc[etiquetados_diana.index].astype(bool) con_claves = etiquetados_diana.dropna(subset=["target_gene", "esqueleto"]) resumen_pares = con_claves.groupby(["esqueleto", "target_gene"])["activo"].agg(["max", "min"]) pares = resumen_pares["max"] activos_par =int(pares.sum()) inactivos_par =len(pares) - activos_par discordantes =int((resumen_pares["max"] != resumen_pares["min"]).sum())print(f" ≥ {u}: {len(etiquetados_diana):,} registros etiquetados con diana; "f"{etiquetados_diana['target_gene'].isna().sum():,} sin gen; "f"{etiquetados_diana['esqueleto'].isna().sum():,} sin esqueleto válido; "f"{len(con_claves):,} registros agrupables → {len(pares):,} pares; "f"{activos_par:,} activos, {inactivos_par:,} inactivos, "f"{100*activos_par/len(pares):.1f}% activos, "f"{discordantes:,} pares con observaciones discordantes, "f"razón {activos_par/inactivos_par:.1f}:1")
cobertura de cada vía:
  A · pChEMBL                129,243
  B · concentración exacta    16,363
  C · inactivo declarado      48,480
  sin vía (se descartan)       8,561

desbalance resultante, con las tres vías aplicadas:
                     umbral  activos  inactivos  % activos razón
pChEMBL >= 5  (= 10,000 nM)   119835      74251       61.7 1.6:1
 pChEMBL >= 6  (= 1,000 nM)    86238     107848       44.4 0.8:1

recuento por par único de esqueleto de conectividad × gen objetivo (target_gene):
  ≥ 5: 109,264 registros etiquetados con diana; 4,810 sin gen; 327 sin esqueleto válido; 104,127 registros agrupables → 71,145 pares; 50,177 activos, 20,968 inactivos, 70.5% activos, 1,810 pares con observaciones discordantes, razón 2.4:1
  ≥ 6: 109,264 registros etiquetados con diana; 4,810 sin gen; 327 sin esqueleto válido; 104,127 registros agrupables → 71,145 pares; 35,966 activos, 35,179 inactivos, 50.6% activos, 2,426 pares con observaciones discordantes, razón 1.0:1
El balance depende del denominador; no debe extrapolarse de registros a pares.
Mirando solo los registros con pChEMBL, el umbral ≥ 5 daba 87.1% de activos y una razón de 6.7 a 1, lo que motivó proponer ≥ 6. Con las tres vías aplicadas, los resultados dependen de la unidad:
Por registro, el denominador es 194,086 etiquetas de todo el archivo, con ensayos fenotípicos incluidos: ≥ 5 da 119,835 activos y 74,251 inactivos (61.7%; 1.6:1); ≥ 6 da 86,238 y 107,848 (44.4%; 0.8:1).
Por par único de esqueleto de conectividad × gen, el denominador es 71,145 pares: ≥ 5 da 50,177 activos y 20,968 inactivos (70.5%; 2.4:1); ≥ 6 da 35,966 y 35,179 (50.6%; 1.0:1). Para esta unidad, ≥ 6 queda prácticamente equilibrado, no por debajo de 50%.
El 6.7:1 describe el subconjunto con pChEMBL. La diferencia observada al incluir las otras vías podría reflejar sesgo de selección, pero estos conteos no identifican su causa. Además, los porcentajes por pares dependen de la regla provisional «activo si alguna observación es activa»: hay 1,810 pares discordantes con ≥ 5 y 2,426 con ≥ 6. La decisión sobre cómo tratar estos conflictos requiere criterio biológico y análisis de sensibilidad. Se conserva ≥ 5 como umbral primario de trabajo y ≥ 6 como análisis de robustez, pendiente de ratificación; el balance de clases por sí solo no determina el umbral farmacológico.
Elegir el umbral por cuál desbalancea menos sería además un argumento de conveniencia estadística, no de farmacología: 10 µM es la concentración de cribado habitual y es lo que justifica el corte, no la proporción resultante.
7. Unidades y conversión
Código
print(d["activity_units_used"].value_counts().to_string())molar = ["nM", "uM", "um", "M", "mM", "pM", "10^3nM", "10^2 uM", "10^6uM", "umol/L"]no_molar = d[~d["activity_units_used"].isin(molar)]print(f"\nregistros en unidades de masa, no convertibles sin peso molecular: {len(no_molar):,}")print(" "+", ".join(f"{k}={v}"for k, v in no_molar["activity_units_used"].value_counts().items()))
activity_units_used
nM         172037
uM          29880
ug.mL-1       535
ug ml-1       114
10^3nM         27
um             23
10^2 uM        14
pg/ml          12
10^6uM          1
M               1
ng/L            1
mM              1
umol/L          1

registros en unidades de masa, no convertibles sin peso molecular: 662
  ug.mL-1=535, ug ml-1=114, pg/ml=12, ng/L=1
La gran mayoría está en nanomolar o micromolar, que se convierten entre sí sin problema. Los 662 registros en µg/mL necesitan el peso molecular del compuesto para pasar a molar — se puede calcular desde el SMILES con RDKit, así que es trabajo, no un bloqueo.
8. Conclusiones
8.1 Las dos etapas casi no comparten compuestos
De los 99,585 esqueletos con actividad medida, solo 1,033 tienen también medición de permeabilidad: el 1.0%. La cadena completa del pipeline no se puede validar experimentalmente más que sobre ese subconjunto.
Esto confirma por una vía independiente la decisión de diseño que ya estaba tomada: la etapa 1 no puede operar como filtro duro. Para el 99% de los compuestos con actividad documentada, su permeabilidad sería una predicción sin verificar, y descartarlos con ella eliminaría candidatos reales.
Reservarlos tiene un costo que hay que decir. Esos 1,033 esqueletos son el 25.7% de los 4,018 del conjunto de permeabilidad. Si se apartan para evaluar la cadena completa, tienen que salir también del entrenamiento de la etapa 1: dejarlos dentro sería fuga, porque el modelo de permeabilidad habría visto justo los compuestos sobre los que se mide el sistema entero.
Es decir, la evaluación de extremo a extremo cuesta un cuarto de los datos de la etapa 1. Es una decisión del proyecto, no un detalle: hay que compararla contra la alternativa de evaluar cada etapa por separado y no medir nunca la cadena completa.
8.2 El criterio de etiquetado excluye justo lo que el proyecto quiere estudiar
Etiquetar con pChEMBL, que es el criterio documentado hasta ahora, descarta en silencio:
Qué se pierde
Registros
Todo NPASS y CMAUP, las bases de productos naturales
15,293
Todas las mediciones censuradas (>= X nM)
54,498
Todos los inactivos declarados por texto
29,730
Son tres pérdidas distintas y las tres apuntan en la misma dirección: se queda la evidencia de ChEMBL con curva dosis-respuesta, que está sesgada hacia compuestos sintéticos bien caracterizados.
La pérdida no es irreparable: 12,809 de los 15,293 registros de NPASS y CMAUP traen valor exacto de concentración, así que una segunda vía de etiquetado los recupera casi enteros.
Propuesta: etiquetar por tres vías, como se detalla en la sección 6.5 — pChEMBL donde exista, concentración exacta para el resto, e inactivo declarado para los textos y los censurados con corte ≥ 10 µM. Hay que documentar cuántos compuestos entran por cada una y reportar el desempeño por separado.
8.3 Umbrales de actividad y unidades de análisis
Sobre los registros con pChEMBL, ≥ 5 deja 87.1% de activos y ≥ 6 deja 63.7%. Con las tres vías, las proporciones cambian según la unidad (sección 6.5): por registro, con 194,086 etiquetas e incluyendo ensayos fenotípicos, son 61.7% para ≥ 5 y 44.4% para ≥ 6; por par único de esqueleto × gen, con 71,145 pares, son 70.5% y 50.6%, respectivamente. El valor de 61.7% no describe el balance de la población por diana, y ≥ 6 no queda por debajo de 50% cuando se mide por pares.
La diferencia observada al pasar de los registros con pChEMBL a las tres vías podría deberse a sesgo de selección en los registros con pChEMBL, pero este análisis no demuestra ese mecanismo. Los pares se forman con los primeros 14 caracteres del InChIKey calculado desde SMILES y el identificador del gen objetivo (target_gene); se excluyen registros sin gen o sin estructura válida. En este recuento, el par se marca activo si alguna observación etiquetada es activa; con esa regla hay 1,810 pares discordantes con ≥ 5 y 2,426 con ≥ 6. El máximo de etiquetas binarias no equivale necesariamente a seleccionar la medición más potente. Por eso los porcentajes por pares son descriptivos y la regla de agregación debe definirse antes de fijar el conjunto de entrenamiento.
Se conserva como propuesta de trabajo pChEMBL ≥ 5 como umbral primario y ≥ 6 como análisis de robustez, con la condición de usar las tres vías y no solo pChEMBL; la decisión sigue abierta a ratificación de la patrocinadora. Elegir el umbral por cuál produce menor desbalance sería un argumento de conveniencia estadística; el corte de 10 µM se apoya en que es la concentración de cribado habitual.
8.4 Hay dos tipos de evidencia mezclados
El 43.5% de los registros no corresponde a ninguna diana de la lista: son ensayos fenotípicos sobre células neuronales, que entraron por la ruta neuronal_assay. Miden que algo pasa, no sobre qué proteína.
La cohorte inicial contiene 114,549 registros con categoría de diana; 109,264 reciben etiqueta por alguna de las tres vías. De estos, 4,810 no tienen gen identificado y 327 no permiten calcular la clave de conectividad, por lo que quedan 104,127 registros agrupables en 71,145 pares. Es un recuento exploratorio previo a resolver las observaciones discordantes y definir la partición: no representa el tamaño del entrenamiento final. Los 88,098 registros sin diana de la lista se conservan para una pregunta distinta —actividad fenotípica— y no se descartan.
8.5 Siguientes pasos
Confirmar con la patrocinadora la definición de actividad, la confiabilidad de los inactivos textuales y el tratamiento de las mediciones censuradas.
Convertir los 662 registros en µg/mL a molar usando el peso molecular de RDKit.
Definir cómo se identifica el compuesto para el modelado y si se agrupan estereoisómeros; la clave de conectividad usada en este EDA los agrupa y no equivale a un andamio Bemis–Murcko.
Resolver o representar las observaciones discordantes para un mismo par estructura de conectividad × gen; cuantificar cómo cambia el balance bajo las reglas candidatas antes de seleccionar una para entrenar.
Decidir si se reservan los 1,033 compuestos comunes para evaluar la cadena completa, sabiendo que cuesta el 25.7% del conjunto de permeabilidad.
Confirmar si el archivo de la patrocinadora contiene una partición de prueba reservada; si no, definir la partición por andamio y evaluar separación por fuente/laboratorio con src/data_prep/splits.py.