Fase 2 — Ingeniería de características y partición
Bioactive AI · Equipo 7 · Maestría en Inteligencia Artificial Aplicada (TC5035.10)
Convierte las mediciones de actividad en la matriz del modelo de la fase 2. Es el equivalente, para la actividad en el sistema nervioso, de lo que el Avance 2 hizo con la permeabilidad, y parte del EDA de actividad.
La diferencia con la fase 1, que organiza todo el notebook
En la fase 1 cada fila era un compuesto y la etiqueta venía dada: bbb_class. Aquí ninguna de las dos cosas es cierta.
El archivo trae mediciones, no compuestos. 202,647 filas, varias por la misma combinación de compuesto y diana, así que la unidad del modelo —el par compuesto-diana— hay que construirla.
La etiqueta no existe en el archivo. No hay columna que diga «activo». Hay concentraciones, y convertirlas en etiqueta exige un umbral que, como se ve en §4, no es estimable con estos datos: se elige y se declara.
De ahí la decisión que da forma a este notebook: no se guarda una etiqueta, se guarda el intervalo donde cae la potencia, y la etiqueta binaria se deriva de él (2.10).
Qué produce
Artefacto
Qué trae
Filas
fase2_pares.parquet
identidad del par, metadatos y las cuatro columnas objetivo
70,384
fase2_descriptores.parquet
los 217 descriptores 2D de RDKit, por compuesto
59,781
fase2_descriptores_limpios.parquet
los mismos tras la limpieza, 201 columnas
59,781
Los construye scripts/construir_pares_fase2.py desde src/data_prep/pares_fase2.py; aquí se cargan y se analizan. El código vive fuera del notebook a propósito: así los tests lo cubren (tests/test_pares_fase2.py) y la matriz se puede reconstruir sin abrir Jupyter.
Qué decide, y qué deja abierto
Decide el formato del objetivo (2.10), la llave del par y los estratos de procedencia (2.3), y la partición agrupada (2.7).
Deja abierto, y lo dice en cada caso: dónde se corta «activo» (2.3, vigente en 10 µM y reversible porque el objetivo se guarda como intervalo), si se clasifica o se predice potencia (2.9, del Avance 4) y qué dianas son prioritarias (2.2).
1. Preparación
Código
import sys, warnings, platformwarnings.filterwarnings("ignore")from pathlib import PathRAIZ = Path.cwd().parent if Path.cwd().name =="notebooks"else Path.cwd()# Se inserta la raíz y no `src/`, al contrario del notebook 02, porque# `src.data_prep.pares_fase2` importa de `src.features` y necesita el paquete# completo. Es la misma ruta que usan los tests.sys.path.insert(0, str(RAIZ))import numpy as npimport pandas as pdimport matplotlib.pyplot as pltimport seaborn as snsimport sklearn, rdkitfrom src.data_prep.pares_fase2 import (CINCO_CATEGORIAS, RANGO_POTENCIA, etiqueta_binaria, grupos_de_pares)from src.data_prep.splits import grupos_cv, verificar_fugafrom src.features.molecular import morgan_plegado, a_molsns.set_theme(style="whitegrid", palette="deep")plt.rcParams.update({"figure.dpi": 110, "figure.figsize": (8, 4.2)})RNG =20261017print(f"Python {platform.python_version()} · pandas {pd.__version__} · numpy {np.__version__}")print(f"scikit-learn {sklearn.__version__} · RDKit {rdkit.__version__}")print(f"Semilla {RNG}")
Las versiones se imprimen porque entre ellas cambian cifras en el tercer decimal, y entre sistemas operativos cambian más: la fase 1 midió 0.481 de MCC en Linux, 0.489 en macOS con Python 3.12 y 0.497 con 3.14 para el mismo modelo. Nada que dependa de una sola corrida se decide aquí.
Código
# `data/processed/` no se versiona (lo excluye el `.gitignore`), así que estos# dos archivos hay que generarlos antes de ejecutar el notebook (~5 minutos):## python scripts/construir_pares_fase2.pyPROCESADOS = RAIZ /"data/processed"pares = pd.read_parquet(PROCESADOS /"fase2_pares.parquet")desc = pd.read_parquet(PROCESADOS /"fase2_descriptores_limpios.parquet")print(f"pares {len(pares):>8,}")print(f"compuestos {pares['esqueleto'].nunique():>8,}")print(f"dianas {pares['target_gene'].nunique():>8,}")print(f"descriptores {desc.shape[1] -1:>8,} (de 217)")pares.head(3)
pares              70,384
compuestos         59,532
dianas                 26
descriptores          201  (de 217)
esqueleto
target_gene
pActividad
n_exactas
n_mediciones
rango_exactas
diana_categoria
andamio
smiles
estrato
...
referencias
ensayos
natural_por_fuente
limite_inferior
limite_superior
conflicto
activo_10um
activo_1um
grupo_cv
particion
0
SRKMMWQNEAUSLE
DRD2
5.008774
1
1
0.000000
Parkinson
c1cnc(N2CCN(Cc3cccc4c3Cc3ccccc3-4)CC2)nc1
c1cnc(N2CCN(Cc3cccc4c3Cc3ccccc3-4)CC2)nc1
solo_chembl
...
CHEMBL1130912
CHEMBL671073
False
5.008774
5.008774
False
True
False
ESRKMMWQNEAUSLE
prueba
1
WDIPTEIUSFFSDV
PPARG
7.697240
2
2
0.993161
Alzheimer
c1ccccc1
CC(/C=C/C(F)=C(/C)c1cc(C(C)(C)C)cc(C(C)(C)C)c1...
solo_chembl
...
CHEMBL1136440
CHEMBL656170;CHEMBL658541
False
7.697240
7.697240
False
True
True
EALYNCZNDIQEVRV
entrenamiento
2
UACZNFHCLLGRTD
NOS2
6.242328
6
6
1.255273
Neuroinflamación
C1=NCCC1
CCCCCC1N=C(N)CC1C.Cl
solo_chembl
...
CHEMBL1131100;CHEMBL1134975
CHEMBL700508;CHEMBL701149
False
6.242328
6.242328
False
True
True
EODHCTXKNWHHXJC
entrenamiento
3 rows × 22 columns
2. De mediciones a pares: qué se guarda y por qué
El objetivo son cuatro columnas, no una:
Columna
Qué es
pActividad
la potencia como número, 6 − log10 µM. Coincide con el pChEMBL donde este existe
limite_inferior, limite_superior
el intervalo donde cae la potencia, con ±∞ cuando no hay cota
activo_10um, activo_1um
la etiqueta binaria, derivada del intervalo
El motivo es una lección de la fase 1 aplicada al revés. El Avance 2 seleccionó sus 171 columnas sobre la matriz transformada con Yeo-Johnson y congeló ese artefacto, así que cambiar la transformación obliga a repetir la selección y a reejecutar el notebook. Guardar solo activo_10um tendría el mismo defecto: adoptar la regresión de la 2.9 obligaría a reconstruir todo.
Con el intervalo guardado, el umbral pasa a ser una decisión de lectura: los tres modelos candidatos leen el mismo archivo.
Los 12,552 pares que solo tienen cotas no son datos faltantes. Un > 10 µM dice que el ensayo llegó a esa concentración sin ver efecto: es evidencia de inactividad, y la mitad de la clase negativa existe únicamente así. Borrarlos —que es lo que hace una regresión sobre mediciones exactas— quita el 49.4% de los negativos y no al azar, porque el 98% de los activos sí tiene medición exacta. Es el argumento de la 2.9.
2.1 El intervalo reproduce la regla del diccionario
La sección 7 del diccionario de la patrocinadora dice que un censurado «solo sirve como negativo si el límite es igual o mayor que el umbral de activo que se use». En escala de potencia eso no hay que programarlo: un > L µM es una cota superior, así que «inactivo con umbral T» es limite_superior ≤ 6 − log10 T.
IC50 = 10 µM con umbral de 10 µM sale activo y IC50 > 10 µM sale inactivo, aunque los dos tengan la misma relación numérica con el corte. Lo que los distingue es que el censurado no tiene cota inferior. Resolver el empate a favor de activo mueve 409 pares, porque los valores redondos son frecuentes en estos ensayos.
IC50 > 1 µM queda sin decidir con 10 µM y es inactivo con 1 µM. Eso es la regla del diccionario, obtenida como consecuencia y no como caso especial.
3. La etiqueta: dos umbrales, y lo que cada uno cuesta
Código
resumen = []for umbral, col in ((10.0, "activo_10um"), (1.0, "activo_1um")): s = pares[col] resumen.append({"umbral": f"{umbral:g} µM","pChEMBL": f"≥ {6- np.log10(umbral):.0f}","con etiqueta": s.notna().sum(),"activos": int(s.sum()),"% activos": f"{s.mean():.1%}","sin decidir": int(s.isna().sum()),"razón de clases": f"{s.sum() / (s.notna().sum() - s.sum()):.2f}:1", })pd.DataFrame(resumen).set_index("umbral")
pChEMBL
con etiqueta
activos
% activos
sin decidir
razón de clases
umbral
10 µM
≥ 5
67736
49332
72.8%
2648
2.68:1
1 µM
≥ 6
69632
34922
50.2%
752
1.01:1
Con 10 µM quedan 2,648 pares sin decidir y la clase está desbalanceada 2.7:1; con 1 µM el conjunto queda casi balanceado y solo 752 pares sin decidir, porque un umbral más estricto convierte más censurados en negativos seguros. Es la misma regla atando los dos extremos que describe la 2.3.
El corte vigente es 10 µM y es una convención del protocolo de tamizaje, no un hallazgo. Es la concentración a la que los ensayos dejaron de mirar: el 67.4% de las 54,377 mediciones censuradas del archivo lo está exactamente en 10 µM, y el comentario de ChEMBL de las filas declaradas inactivas lo dice literalmente («Inhibition < 50% @ 10 uM»). Lo que sí es medible favorece 1 µM —más censurados aprovechables, clases casi balanceadas y más pares etiquetados—, así que 10 µM se conserva como principal por comparabilidad con el diccionario y los dos se reportan al lado (2.3).
4. Lo que la etiqueta esconde, y es la sección que hay que leer
Tres cosas que un número agregado tapa. Todas se reportan junto a cualquier métrica, y las tres salen de este mismo artefacto.
4.1 El mismo umbral no mide lo mismo en cada diana
Código
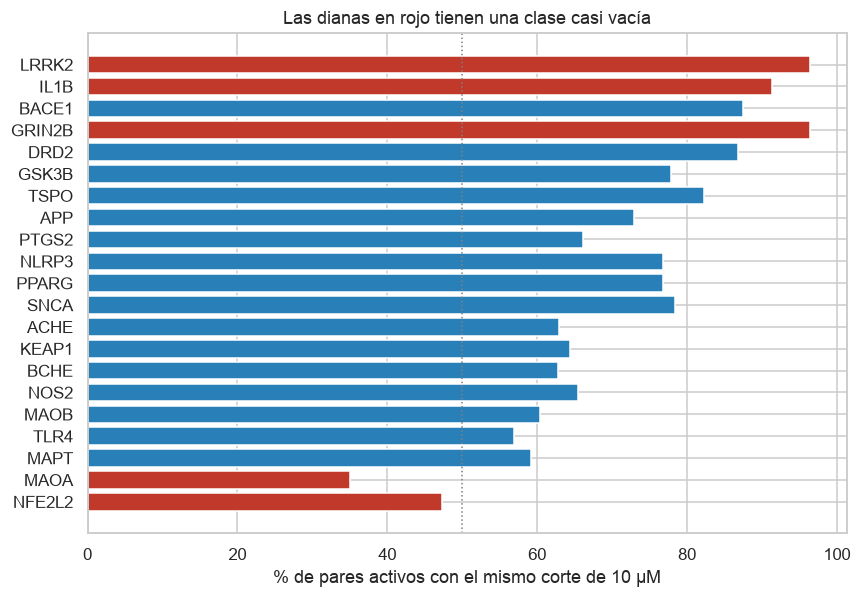
por_diana = (pares.groupby("target_gene") .agg(pares=("activo_10um", "size"), activos=("activo_10um", "mean"), potencia_mediana=("pActividad", "median")) .sort_values("potencia_mediana", ascending=False))grandes = por_diana[por_diana["pares"] >=200]fig, ax = plt.subplots(figsize=(8, 5.6))ax.barh(grandes.index, grandes["activos"] *100, color=np.where(grandes["activos"] >0.9, "#c0392b", np.where(grandes["activos"] <0.5, "#c0392b", "#2980b9")))ax.axvline(50, color="grey", ls=":", lw=1)ax.set_xlabel("% de pares activos con el mismo corte de 10 µM")ax.set_title("Las dianas en rojo tienen una clase casi vacía")ax.invert_yaxis()plt.tight_layout(); plt.show()print(f"de {grandes['activos'].min():.1%} ({grandes['activos'].idxmin()})"f" a {grandes['activos'].max():.1%} ({grandes['activos'].idxmax()})")print(f"mediana de potencia: de {grandes['potencia_mediana'].min():.2f}"f" a {grandes['potencia_mediana'].max():.2f}"f" ({10** (grandes['potencia_mediana'].max() - grandes['potencia_mediana'].min()):,.0f}×)")
de 35.0% (MAOA) a 96.5% (LRRK2)
mediana de potencia: de 5.02 a 7.40  (241×)
Con un solo corte, LRRK2 queda con el 96.5% de sus pares activos y MAOA con el 35.0%. La etiqueta no mide lo mismo: en LRRK2 es casi constante y como objetivo de clasificación aporta poco, mientras que en MAOA separa de verdad.
La causa es que la potencia intrínseca de cada diana difiere en dos órdenes de magnitud, y el corte es el mismo para todas. Y los experimentadores ya lo sabían: el límite de censura que eligieron va de 1 µM en LRRK2 a 100 µM en NOS2, en el mismo orden. Se intentó usar esa moda como umbral por diana y falló: está condicionada al fracaso —es el techo de los ensayos que no encontraron nada— y dejaba seis dianas con 93–96% de activos, peor que el corte global (2.3).
Mientras el corte siga siendo global, esta figura acompaña cualquier cifra agregada.
4.2 La procedencia está confundida con la etiqueta
La fuente no es un atributo del par: 827 de los 828 pares de CMAUP comparten par con otra fuente, así que «activos de CMAUP» describiría un grupo que casi no existe. Por eso se reporta en estratos disjuntos por procedencia de la evidencia.
63 puntos de diferencia entre solo_chembl y solo_npass, y no es un artefacto del etiquetado: es química real. La mediana de potencia de las mediciones de NPASS es 6.56 µM contra 0.335 µM en ChEMBL, veinte veces, así que el corte de 10 µM cae casi en la mediana de los naturales y a treinta veces de la de ChEMBL. Para los naturales la etiqueta la decide el ruido de medición; para ChEMBL es estable.
Eso es la preocupación de la patrocinadora sobre comparabilidad, en la forma que sí se puede medir —no la que ella nombró, que era el tejido, y que no se puede comprobar porque la columna está vacía en las 108,640 filas de la ruta cns_target—.
Consecuencia operativa: la procedencia nunca entra como característica, porque un compuesto nuevo no la tiene, y el desempeño se reporta por estrato. Si el control de atajo del #32 —un modelo que solo ve procedencia, sin química— se acerca al modelo real, la fuente está filtrando la etiqueta.
4.3 La dispersión entre mediciones del mismo par
Código
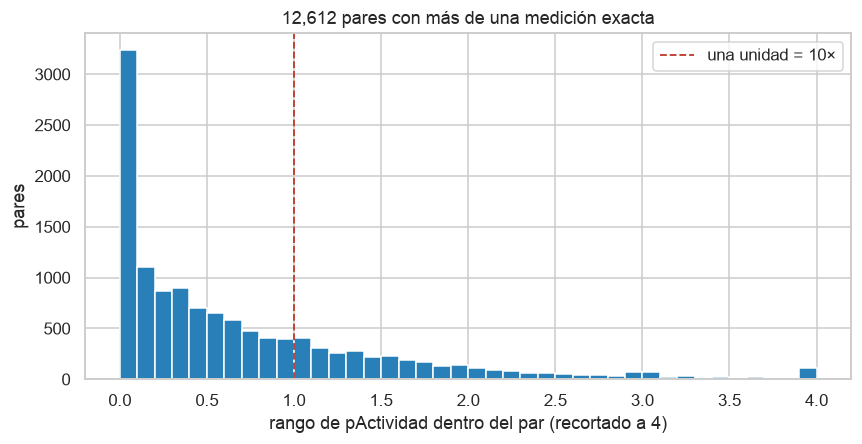
multi = pares[pares["n_exactas"] >1]fig, ax = plt.subplots()ax.hist(multi["rango_exactas"].clip(upper=4), bins=40, color="#2980b9")ax.axvline(1, color="#c0392b", ls="--", lw=1.2, label="una unidad = 10×")ax.set_xlabel("rango de pActividad dentro del par (recortado a 4)")ax.set_ylabel("pares"); ax.legend()ax.set_title(f"{len(multi):,} pares con más de una medición exacta")plt.tight_layout(); plt.show()print(f"mediana {multi['rango_exactas'].median():.2f} · "f"p90 {multi['rango_exactas'].quantile(.9):.2f}")print(f"pares que discrepan más de 10×: {(multi['rango_exactas'] >1).sum():,}"f" ({(multi['rango_exactas'] >1).mean():.1%})")
mediana 0.43 · p90 1.80
pares que discrepan más de 10×: 3,222 (25.5%)
Un cuarto de los pares con varias mediciones discrepan más de 10× entre ellas, y el 98.6% de esos casos tiene el mismo formato de ensayo anotado —o, más exactamente, ninguno, porque la columna está vacía—. No se puede saber si el tejido lo explica.
Por eso la agregación usa la mediana y no el valor más potente. El máximo sesga hacia la clase positiva, y con la mediana la dispersión deja de ser «conflicto»: dos mediciones a los lados del corte son ruido de medición, no contradicción. Así los conflictos bajan de 1,784 a 1,126, y de esos solo 15 dan un intervalo vacío. La información no se pierde —vive en rango_exactas— así que un análisis de robustez puede excluir los pares dispersos sin volver a leer el archivo.
5. Las características
Las mismas de la fase 1, por la 1.3: descriptores 2D de RDKit más Morgan/ECFP4 de 2048 bits. Lo que cambia es la unidad: se calculan por compuesto, no por par, y el modelado une por smiles. Guardarlos por par repetiría cada fila 1.18 veces en promedio, y mucho más para los compuestos medidos contra varias dianas.
Código
print(f"descriptores utilizables: {desc.shape[1] -1} de 217")print(f"compuestos: {len(desc):,}")# Qué se descartó y por qué, recalculado aquí para que la cifra tenga corrida detráscrudos = pd.read_parquet(PROCESADOS /"fase2_descriptores.parquet")fuera =sorted(set(crudos.columns) -set(desc.columns))print(f"\ndescartados ({len(fuera)}): {', '.join(fuera)}")
Quedan 201 de 217, dos menos que los 203 de la fase 1. No es un criterio distinto: es el mismo limpiar_descriptores, sobre otro conjunto de compuestos, así que cambian las columnas que salen constantes o no finitas.
Los 16 que se van son de tres clases. Los cuatro PartialCharge y los ocho BCUT2D_* dependen de la asignación de cargas parciales de Gasteiger, que no converge para todas las moléculas y devuelve NaN; Ipc se desborda en float32 para moléculas grandes, que aquí abundan más que en el conjunto de permeabilidad; y SMR_VSA8, SlogP_VSA9 y fr_diazo son constantes en estos 59,781 compuestos.
5.1 Correlación y asimetría
No se vuelve a medir qué transformación conviene: la 1.5 ya lo midió con validación cruzada agrupada y tres semillas, y el resultado fue que entre las tres formas de escalar la medición no distingue, que la razón para escalar es la convergencia —sin escalar la regresión logística agota sus iteraciones— y que Yeo-Johnson es la única con un motivo medido para evitarla. Aquí solo se comprueba que el diagnóstico de la fase 1 también describe esta matriz.
Código
X = desc.drop(columns="smiles")corr = X.corr().abs()triangulo = corr.where(np.triu(np.ones(corr.shape), k=1).astype(bool))muy_correlacionados = (triangulo >0.95).sum().sum()asimetria = X.skew().abs()print(f"pares de descriptores con |r| > 0.95: {muy_correlacionados:,}")print(f"descriptores con |asimetría| > 2: {(asimetria >2).sum()} de {X.shape[1]}")print(f"amplitud de los rangos: de {(X.max() - X.min()).min():.3g}"f" a {(X.max() - X.min()).max():,.0f}")
pares de descriptores con |r| > 0.95:  114
descriptores con |asimetría| > 2:      154 de 201
amplitud de los rangos: de 0.945 a 11,374
El mismo cuadro de la fase 1, y más marcado: los rangos difieren en varios órdenes de magnitud, así que un modelo lineal trataría al descriptor más amplio como si pesara miles de veces más por sus unidades y no por su contenido. Los árboles son indiferentes —solo miran el orden— así que reciben la matriz sin transformar, y la regresión logística lleva min–max como punto de partida.
5.2 Morgan/ECFP4
radius=2 da ECFP4, porque el nombre lleva el diámetro. Se usa rdFingerprintGenerator y no el GetMorganFingerprintAsBitVect deprecado.
Código
mols = [a_mol(s) for s in desc["smiles"]]huellas = morgan_plegado([m for m in mols if m isnotNone], radio=2, n_bits=2048)print(f"huellas: {huellas.shape[0]:,} × {huellas.shape[1]:,}")ocupacion = huellas.sum(axis=0)densidad = huellas.sum(axis=1)print(f"bits nunca activados: {(ocupacion ==0).sum():,}")print(f"bits en más del 50% de las moléculas: {(ocupacion >0.5*len(huellas)).sum():,}")print(f"bits activos por molécula: mediana {np.median(densidad):.0f}"f" · p90 {np.percentile(densidad, 90):.0f}")
huellas: 59,781 × 2,048
bits nunca activados:        0
bits en más del 50% de las moléculas: 13
bits activos por molécula:   mediana 52 · p90 66
6. La partición: agrupada por estructura, nunca aleatoria
La 1.2 lo fijó para la fase 1 con una razón medida: una partición aleatoria infla los resultados entre 7 y 13 puntos, porque deja análogos casi idénticos a los dos lados y el modelo memoriza el andamiaje en lugar de generalizar.
Aquí hay un motivo adicional que no existía en la fase 1. La patrocinadora había reservado un 10% al azar, y en la reunión del 15 de octubre aceptó el argumento y entregó el archivo completo para que el equipo rehiciera la partición (2.6). Su única condición fue que se reserve una prueba que el modelo nunca vea.
El grupo es el esqueleto de conectividad unido al andamio de Bemis-Murcko, salvo en los acíclicos: todos comparten el marcador <aciclico>, y unirlos por ahí los fundiría en un solo grupo gigante.
Código
grupos = pares["grupo_cv"].to_numpy()tam = pd.Series(grupos).value_counts()print(f"grupos: {len(tam):,} para {len(pares):,} pares")print(f" mediana {tam.median():.0f} pares por grupo · p99 {tam.quantile(.99):.0f}"f" · máximo {tam.max():,}")print(f" grupos de un solo par: {(tam ==1).sum():,} ({(tam ==1).mean():.1%})")
grupos: 24,230 para 70,384 pares
  mediana 1 pares por grupo · p99 28 · máximo 1,255
  grupos de un solo par: 14,492 (59.8%)
6.1 La prueba reservada, que es la condición de la patrocinadora
Una validación cruzada de cinco pliegues no cumple esa condición: ahí cada par entra en la evaluación de algún pliegue. Así que la partición en tres se calcula en scripts/construir_pares_fase2.py y viaja en el artefacto, no en una celda de este notebook — si viviera aquí, cada reejecución podría moverla.
Usa scaffold_split, las mismas fracciones que la fase 1 (20% prueba, 10% validación) y el mismo criterio: los andamios frecuentes alimentan el modelo y los raros quedan para evaluar química nueva.
Tres cosas que esta tabla dice y que cambian cómo se leerá cualquier métrica:
La prueba son 13,973 pares en 13,973 grupos: un andamio por par. No es un defecto de la partición, es su semántica llevada al límite por la cola larga de la fase 2 —el 59.8% de los grupos tiene un solo par—. Mide generalización a química que el modelo no vio nunca, que es lo que se quiere, pero no es una muestra representativa del conjunto.
La prueba tiene más activos que el entrenamiento: 78.7% contra 71.6%. Así que no es una prueba uniformemente más difícil, es una población distinta. La fase 1 tiene la misma propiedad y en mayor grado (57.3% en prueba contra 64.0% en entrenamiento), porque scaffold_split agrupa por estructura y no estratifica por clase. Hay que reportar la tasa base de cada partición al lado de cualquier métrica, o un AUPRC de prueba no es comparable con uno de validación.
Código
# Los naturales no se reparten como el resto, y eso limita qué se puede evaluarorigen = pd.crosstab(pares["particion"], pares["estrato"]).reindex( ["entrenamiento", "validacion", "prueba"])origen["% de los solo_npass"] = (origen["solo_npass"]/ origen["solo_npass"].sum()).map("{:.1%}".format)origen
estrato
mixto
solo_chembl
solo_cmaup
solo_npass
% de los solo_npass
particion
entrenamiento
1463
45956
1
2005
89.9%
validacion
136
6741
0
109
4.9%
prueba
229
13627
0
117
5.2%
Y el tercero es el que más aprieta: los productos naturales se concentran en entrenamiento. De los 2,231 pares con evidencia solo de NPASS, apenas el 5.2% cae en la prueba, y el único par de CMAUP queda en entrenamiento. La causa es mecánica: los naturales comparten andamios en familias grandes —flavonoides, alcaloides— y scaffold_split manda los grupos grandes a entrenamiento.
El efecto es el contrario del que el proyecto quiere: la evaluación por origen sobre la prueba reservada descansa en 117 pares de NPASS y 229 mixtos. Es suficiente para una señal gruesa y no para comparar desempeño por origen con intervalos. Queda declarado como límite, y la salida —estratificar la partición por origen, o evaluar el origen solo en validación cruzada sobre entrenamiento— es una decisión del Avance 3.
Código
from sklearn.model_selection import StratifiedGroupKFold# La prueba queda fuera: la validación cruzada solo ve entrenamiento y# validación. Es la diferencia con la versión anterior de esta celda, que# partía los 66,121 pares etiquetados completos y por tanto evaluaba también# sobre la prueba reservada.ajustable = pares["activo_10um"].notna() & pares["particion"].ne("prueba")y = pares.loc[ajustable, "activo_10um"].astype(int).to_numpy()g = pares.loc[ajustable, "grupo_cv"].to_numpy()print(f"{ajustable.sum():,} pares para ajustar y validar"f" · {pares['particion'].eq('prueba').sum():,} reservados")cv = StratifiedGroupKFold(n_splits=5, shuffle=True, random_state=RNG)pliegues =list(cv.split(np.zeros(len(y)), y, g))filas = []for i, (ajuste, val) inenumerate(pliegues, 1): filas.append({"pliegue": i, "ajuste": len(ajuste), "validación": len(val),"% activos en validación": f"{y[val].mean():.1%}","grupos compartidos": len(set(g[ajuste]) &set(g[val]))})pd.DataFrame(filas).set_index("pliegue")
54,369 pares para ajustar y validar · 13,973 reservados
ajuste
validación
% activos en validación
grupos compartidos
pliegue
1
43496
10873
71.4%
0
2
43491
10878
71.4%
0
3
43498
10871
71.4%
0
4
43494
10875
71.4%
0
5
43497
10872
71.4%
0
Cero grupos compartidos en los cinco pliegues, que es la propiedad que hace comparable la evaluación, y la proporción de activos se mantiene estable porque la estratificación la respeta.
Código
# La comprobación de fuga, sobre la partición guardada y no sobre un plieguefrom src.data_prep.splits import SIN_ANDAMIOmarca = pares[pares["activo_10um"].notna()].copy()marca["andamio"] = marca["andamio"].fillna(SIN_ANDAMIO)marca["y"] = marca["activo_10um"].astype(int)informe = verificar_fuga(marca)print(f"sin fuga: {informe['sin_fuga']}")print(f" andamios cruzados {informe['andamios_cruzados']}")print(f" esqueletos cruzados {informe['esqueletos_cruzados']}")print(f" tamaños {informe['tamanos']}")print(f" balance {informe['balance']}")
6.3 Por diana: pares, grupos y balance en los pliegues
La 2.2 decide un modelo por diana para las 14 con mil pares o más. Un modelo por diana significa catorce particiones, y una tabla agregada esconde si alguna queda sin clase minoritaria en algún pliegue. Esta es la comprobación que faltaba: para cada diana, cuántos pares y grupos quedan tras reservar la prueba, y cuál es el mínimo de positivos y de negativos que ve un pliegue de validación.
Código
sub = pares.loc[ajustable, ["target_gene", "grupo_cv", "activo_10um"]].reset_index(drop=True)sub["y"] = sub["activo_10um"].astype(int)filas = []for diana, gg in sub.groupby("target_gene"): pos_min = neg_min =Nonefor _, val in pliegues: en_val = gg.index.intersection(val)iflen(en_val) ==0: pos_min = neg_min =0break pos =int(gg.loc[en_val, "y"].sum()) neg =len(en_val) - pos pos_min = pos if pos_min isNoneelsemin(pos_min, pos) neg_min = neg if neg_min isNoneelsemin(neg_min, neg) filas.append({"diana": diana, "pares": len(gg),"grupos": gg["grupo_cv"].nunique(),"activos": gg["y"].mean(),"mín. positivos en un pliegue": pos_min,"mín. negativos en un pliegue": neg_min})por_diana_pliegues = (pd.DataFrame(filas).set_index("diana") .sort_values("pares", ascending=False))por_diana_pliegues["activos"] = por_diana_pliegues["activos"].map("{:.1%}".format)por_diana_pliegues
pares
grupos
activos
mín. positivos en un pliegue
mín. negativos en un pliegue
diana
BACE1
6542
1396
88.9%
1064
135
DRD2
6118
1555
86.2%
886
130
ACHE
6001
2200
62.5%
687
384
MAOB
5246
1626
59.8%
483
371
MAOA
4588
1799
34.8%
258
548
PTGS2
4197
846
66.0%
434
247
GSK3B
4002
1098
80.3%
553
127
BCHE
3936
1631
61.9%
412
271
PPARG
3362
689
76.4%
400
132
LRRK2
2709
698
96.8%
465
13
GRIN2B
1592
172
96.9%
171
5
APP
1428
388
75.2%
158
59
NFE2L2
1114
400
46.5%
81
77
MAPT
795
348
57.9%
68
37
NOS2
721
205
65.6%
51
20
NLRP3
498
153
77.5%
52
9
SNCA
389
160
77.4%
41
12
KEAP1
308
75
60.7%
22
16
IL1B
182
49
94.5%
18
0
TLR4
163
41
66.9%
7
5
TSPO
150
58
82.0%
14
0
COMT
107
33
80.4%
6
2
GRIN1
88
27
92.0%
1
0
IL6
62
18
98.4%
8
0
CX3CR1
58
19
89.7%
2
0
TNF
13
12
69.2%
0
0
Código
# Lo que decide si la 2.2 es ejecutable: dónde se rompe el modelo por dianaumbral_pares =1000grandes = por_diana_pliegues[por_diana_pliegues["pares"] >= umbral_pares]chicas = por_diana_pliegues[por_diana_pliegues["pares"] < umbral_pares]pocos = (chicas["mín. negativos en un pliegue"] <10).sum()vacios = ((chicas["mín. positivos en un pliegue"] ==0)| (chicas["mín. negativos en un pliegue"] ==0)).sum()print(f"dianas con {umbral_pares:,} pares o más: {len(grandes)}"f" ({grandes['pares'].sum():,} pares, {grandes['pares'].sum() /len(sub):.1%})")print(f" mínimo de positivos en un pliegue: {grandes['mín. positivos en un pliegue'].min()}")print(f" mínimo de negativos en un pliegue: {grandes['mín. negativos en un pliegue'].min()}"f" ({grandes['mín. negativos en un pliegue'].idxmin()})")print(f"\ndianas por debajo: {len(chicas)} ({chicas['pares'].sum():,} pares)")print(f" con menos de 10 negativos en algún pliegue: {pocos}")print(f" con algún pliegue sin positivos o sin negativos: {vacios}")
dianas con 1,000 pares o más: 13  (50,835 pares, 93.5%)
  mínimo de positivos en un pliegue: 81
  mínimo de negativos en un pliegue: 5  (GRIN2B)

dianas por debajo: 13  (3,534 pares)
  con menos de 10 negativos en algún pliegue: 9
  con algún pliegue sin positivos o sin negativos: 6
Lo que esta tabla decide, y cambia la 2.2. El criterio «las 14 dianas con mil pares o más» no sobrevive a la comprobación. Al reservar la prueba quedan 13 por encima de mil pares, y de esas, dos no sostienen un modelo propio aunque tengan volumen:
LRRK2, con 2,709 pares y 96.8% de activos, deja un pliegue con 13 negativos.
GRIN2B, con 1,592 pares pero solo 172 grupos, y 96.9% de activos, deja un pliegue con 5.
Con esa clase minoritaria no hay métrica por pliegue con error estándar interpretable, ni punto de operación elegible. Así que el criterio pasa a ser una condición y no un número: mil pares o más y cincuenta casos de la clase minoritaria en todos los pliegues, que deja once dianas, el 85.6% de los pares ajustables. Las otras quince entran al multitarea y se reportan como subgrupo.
Y en la cola el problema es más duro: seis dianas tienen algún pliegue sin positivos o sin negativos —GRIN1 con 88 pares y un pliegue de un solo positivo es el caso extremo—. Si la patrocinadora pide priorizar una de esas, la respuesta no es entrenarle un modelo: es esta cifra.
6.4 Por artículo disjunto: la validación que no se puede hacer
La sección 9 de la propuesta de variable objetivo planteaba agrupar también por reference_id, para probar el modelo en artículos que no vio. Suena fácil, porque el 93.8% de los pares tiene una sola referencia. No lo es: los compuestos medidos en varios artículos enlazan las referencias entre sí, así que los grupos disjuntos no son los artículos sino los componentes conexos del grafo que forman.
Lo midió Pame al revisar el #86, con las referencias que el artefacto guarda desde esta misma rama.
Código
from scipy.sparse import coo_matrixfrom scipy.sparse.csgraph import connected_components# Un par por fila, una referencia por columna; dos pares quedan conectados si# comparten al menos una referencia.ref_id, fila, col = {}, [], []for i, refs inenumerate(pares["referencias"].str.split(";")):for r infilter(None, refs): fila.append(i) col.append(ref_id.setdefault(r, len(ref_id)))incidencia = coo_matrix((np.ones(len(fila)), (fila, col)), shape=(len(pares), len(ref_id))).tocsr()n_comp, comp = connected_components(incidencia @ incidencia.T, directed=False)tam = pd.Series(comp).value_counts()print(f"referencias distintas {len(ref_id):>8,}")print(f"pares con una sola referencia {(pares['n_referencias'] ==1).mean():>8.1%}")print(f"componentes conexos {n_comp:>8,}")print(f" el mayor {tam.iloc[0]:>8,}"f" ({tam.iloc[0] /len(pares):.1%} de los pares)")print(f" el segundo {tam.iloc[1]:>8,}")print(f" de un solo par {(tam ==1).sum():>8,}")
referencias distintas             7,493
pares con una sola referencia     93.8%
componentes conexos               2,251
  el mayor                       39,362  (55.9% de los pares)
  el segundo                        601
  de un solo par                    538
Un componente reúne el 55.9% de los pares y el siguiente tiene 601. No es un reparto desequilibrado que se pueda balancear: es un bloque mayoritario y polvo. Cualquier partición disjunta por artículo pondría más de la mitad de los datos de un lado, y la prueba —o un pliegue— sería ese bloque.
Así que la validación por artículo disjunto no se hace en su versión estricta, y queda registrado como variante no viable en la tabla de robustez, al lado de la estratificación por tejido. Las dos aproximaciones que sí caben con estos datos —reportar el desempeño por referencia dentro de la validación cruzada, o agrupar cada par por su referencia principal aceptando algo de fuga— se deciden en el Avance 3, cuando se pueda medir cuánta fuga deja la segunda.
Vale la pena ver por qué aparece el bloque: con 7,493 referencias y 70,384 pares, basta una minoría de compuestos medidos en muchos artículos para coser casi todo. Es la misma lección que el esqueleto de conectividad en la fase 1 —la unidad independiente no es la que parece— aplicada a otra columna.
7. Qué queda guardado, y qué decide el modelado
Los tres artefactos de data/processed/ los produce scripts/construir_pares_fase2.py, y no se versionan porque el .gitignore excluye esa carpeta: hay que generarlos antes de ejecutar este notebook, que no los reescribe sino que los audita. Lo que no se decide aquí, a propósito:
Si la partición se estratifica por origen, para poder evaluar los naturales en prueba
Avance 3; hoy el 94.8% de los pares de NPASS cae en entrenamiento
Dónde se corta «activo»
2.3, vigente en 10 µM con 1 µM al lado; el 20.7% de las mediciones exactas cae a ±0.5 unidades logarítmicas del corte
Lo que este notebook deja establecido
La unidad del modelo es el par compuesto-diana, con llave de esqueleto de conectividad × gen y no de identificador de compuesto, porque los identificadores no se comparten entre fuentes y 164 conflictos quedarían invisibles.
El objetivo se guarda como intervalo, así que el umbral es una decisión de lectura y los tres modelos candidatos leen el mismo archivo.
El corte de 10 µM es una convención del protocolo, no una cota farmacológica: es la concentración a la que estos ensayos dejaron de mirar. No hay umbral estimable sin desenlace, y el archivo no tiene ninguno; lo medible favorece 1 µM y los dos se reportan al lado.
Tres cosas acompañan siempre a cualquier métrica: la tasa de activos por diana (35.0% a 96.5%), el desempeño por estrato de procedencia (63 puntos de brecha) y el control de atajo.
La partición agrupa por estructura, reserva una prueba del 20% que la validación cruzada no toca, y no comparte ni un grupo ni un esqueleto entre particiones.
Tres límites de esa partición quedan medidos, no escondidos: la prueba es un andamio por par, tiene 7 puntos más de activos que el entrenamiento, y solo el 5.2% de los pares de NPASS cae en ella, así que la evaluación por origen sobre la prueba descansa en 346 pares.
La 2.2 tiene su límite: por diana es ejecutable para las grandes, y en la cola la clase minoritaria no alcanza para una métrica por pliegue.