Avance 2 — Ingeniería de características y partición
Bioactive AI · Equipo 7 · Maestría en Inteligencia Artificial Aplicada (TC5035.10)
Convierte los SMILES en la matriz de características del modelo y construye la partición de evaluación. Parte de las decisiones del Avance 1.
Qué produce
Descriptores 2D de RDKit (217) más Morgan/ECFP4 de 2048 bits.
Sort & Slice como alternativa libre de colisiones, con el vocabulario aprendido solo del entrenamiento.
Una partición por andamio verificada sin fuga, ni de andamio ni de estereoisómero.
El umbral de TPSA rederivado sobre entrenamiento, no tomado de la literatura.
Decisiones que hereda del Avance 1
La fuente es el conjunto curado por la patrocinadora, no los archivos de B3DB que el equipo descargó. Viene con los SMILES estandarizados y con el cruce contra COCONUT, que identifica qué compuestos son productos naturales.
No se filtra por la columna group. El Avance 1 mostró que las categorías A–D no son una escala de calidad: el grupo D tiene más respaldo bibliográfico que el C, y restringir a A+B dejaría la clase minoritaria en 27.0% frente al 36.5% del conjunto completo. El filtro acentúa el desbalance en lugar de depurar ruido. La columna se conserva para describir y estratificar.
Scaffold split obligatorio. Los andamios grandes tienen pureza de clase extrema: uno de 410 compuestos es 99.5% BBB+. Con partición aleatoria basta reconocer el andamio.
El origen natural o sintético se arrastra hasta la matriz final. El Avance 1 encontró que los productos naturales cruzan la barrera 18.9 puntos menos, así que el desempeño tendrá que reportarse por separado en ambos grupos.
Lo que aquí se decide, y lo que no
Escalar o no, qué transformación y si se extraen componentes son propuestas, no decisiones cerradas: la decisión 1.5 del registro sigue abierta. Cada una se mide y se ejecuta una, pero la alternativa se nombra y se deja viable:
Lo que se ejecuta
La alternativa, que sigue en pie
Escalamiento
las tres transformaciones ajustadas sobre entrenamiento
no escalar, defendible para árboles, que son invariantes a transformaciones monótonas
Extracción
la matriz filtrada de 151 columnas
el PCA, que no se adopta ni se guarda: un componente es una combinación lineal y no se traduce a una subestructura. Queda como vista del espacio químico
Por eso la matriz se guarda dos veces, normalizada y sin normalizar, con las mismas columnas y en el mismo orden: el Avance 3 puede tomar cualquiera sin volver a correr nada.
Nada de esto está ratificado. Los acuerdos y las decisiones definitivas se revisan con la patrocinadora, que es quien decide; hasta entonces lo que está aquí es lo que el equipo propone, con su medición al lado.
import sys, warningswarnings.filterwarnings("ignore")from pathlib import PathRAIZ = Path.cwd().parent if Path.cwd().name =="notebooks"else Path.cwd()sys.path.insert(0, str(RAIZ /"src"))import numpy as npimport pandas as pdimport matplotlib.pyplot as pltimport seaborn as snsfrom features.molecular import (a_mol, descriptores_rdkit, limpiar_descriptores, morgan_plegado, substructura_de_bit, SortAndSlice, DESCRIPTORES_CLAVE)from data_prep.splits import (andamio_murcko, esqueleto_conectividad, scaffold_split, verificar_fuga, umbral_youden, SIN_ANDAMIO)# Los modelos y las métricas se importan aquí y no donde se usan por primera vez:# la §9 los necesita para medir qué cuesta el filtrado y la §11 para la tabla# comparativa, así que importarlos en la §11 rompía la ejecución secuencial que# pide la rúbrica.from sklearn.linear_model import LogisticRegressionfrom sklearn.ensemble import RandomForestClassifierfrom sklearn.preprocessing import StandardScalerfrom sklearn.pipeline import make_pipelinefrom sklearn.metrics import (matthews_corrcoef, average_precision_score, roc_auc_score, balanced_accuracy_score)sns.set_theme(style="whitegrid", palette="colorblind")plt.rcParams["figure.dpi"] =110SEMILLA =42
Código
# Versiones con las que se ejecutó este notebook. `requirements.txt` solo fija cotas# inferiores, y entre versiones de scikit-learn cambian en el tercer decimal las cifras# de Random Forest y de la regresión logística. Con una sola partición de validación,# la regresión logística con min–max da 0.481 de MCC en Linux con Python 3.12, 0.489 en# macOS con 3.12 y 0.497 en macOS con 3.14; con esta línea cualquier salida es# rastreable a su entorno.import platform, scipy, sklearn, rdkit, matplotlib, seaborn, joblibprint(f"sistema {platform.platform()}")print(f"python {platform.python_version()}")for m in (np, pd, scipy, sklearn, rdkit, matplotlib, seaborn, joblib):print(f"{m.__name__:<12}{m.__version__}")
Se usan todas las filas con clase asignada. La columna group se conserva como variable descriptiva, no como criterio de exclusión.
Código
PROF = RAIZ /"data/external/profesora/bbb_permeability_experimental.csv"b3db = pd.read_csv(PROF)b3db.columns = [c.strip().lstrip("\ufeff") for c in b3db.columns]b3db = b3db.rename(columns={"smiles_std": "SMILES", "bbb_class": "BBB+/BBB-", "logbb": "logBB","b3db_uncertainty_classification": "group", "inchikey": "Inchi"})b3db["mol"] = b3db["SMILES"].map(a_mol)invalidos = b3db["mol"].isna().sum()# el conjunto de trabajo son las filas con clase asignada y estructura válidad = b3db.dropna(subset=["mol", "BBB+/BBB-"]).reset_index(drop=True)d["y"] = (d["BBB+/BBB-"] =="BBB+").astype(int)# el cruce con COCONUT marca qué compuestos son productos naturalesd["natural"] = d["coconut_id_exact_match"].notna()print(f"archivo de la patrocinadora : {len(b3db)} filas ({invalidos} SMILES inválidos)")print(f"conjunto de trabajo : {len(d)} compuestos · {d['y'].mean()*100:.1f}% BBB+")print(f"razón de desbalance : {(1-d['y'].mean())/d['y'].mean():.2f} negativos por positivo\n")print("composición por grupo (se describe, NO se filtra):")for g, sub in d.groupby("group"):print(f" {g}: {len(sub):>5} compuestos · {sub['y'].mean()*100:5.1f}% BBB+")print(f"\nproductos naturales : {d['natural'].sum()} ({d['natural'].mean()*100:.1f}%)")# qué habría pasado filtrando a A+B, que es la decisión que el Avance 1 descartóab = d[d["group"].isin(["A", "B"])]print(f"\n[contraste] filtrar a A+B daría {len(ab)} compuestos con "f"{(1-ab['y'].mean())*100:.1f}% de clase minoritaria,")print(f" contra {(1-d['y'].mean())*100:.1f}% del conjunto completo: "f"el filtro empeora el desbalance.")
archivo de la patrocinadora : 7811 filas (0 SMILES inválidos)
conjunto de trabajo         : 7805 compuestos · 63.5% BBB+
razón de desbalance         : 0.57 negativos por positivo

composición por grupo (se describe, NO se filtra):
  A:  1058 compuestos ·  87.9% BBB+
  B:  3621 compuestos ·  68.7% BBB+
  C:  3075 compuestos ·  50.0% BBB+
  D:    51 compuestos ·   7.8% BBB+

productos naturales         : 3366 (43.1%)

[contraste] filtrar a A+B daría 4679 compuestos con 27.0% de clase minoritaria,
            contra 36.5% del conjunto completo: el filtro empeora el desbalance.
3. Partición por andamio
Código
d["andamio"] = [andamio_murcko(m) for m in d["mol"]]d["esqueleto"] = [esqueleto_conectividad(m) for m in d["mol"]]print(f"andamios de Murcko distintos : {d['andamio'].nunique()}")print(f"esqueletos de conectividad : {d['esqueleto'].nunique()}")print(f"compuestos acíclicos : {(d['andamio']==SIN_ANDAMIO).sum()}")print(f"\ntamaño efectivo de muestra: {d['esqueleto'].nunique()} entidades, no {len(d)} filas")
andamios de Murcko distintos : 3629
esqueletos de conectividad   : 4018
compuestos acíclicos         : 312

tamaño efectivo de muestra: 4018 entidades, no 7805 filas
3.1 Dirección de la asignación
Un detalle que parece menor y no lo es: los grupos grandes van a entrenamiento, no a prueba.
Al construir la partición al revés —llenando primero la prueba con los andamios más frecuentes— resultaba un conjunto de evaluación con 45 andamios contra 2,112 del entrenamiento, y el benceno solo ocupaba el 26% de la prueba. El desempeño medido ahí reflejaría esos pocos quimiotipos, no la capacidad del modelo.
La convención correcta, la de DeepChem, deja los andamios raros para evaluar: eso es lo que mide generalización a química nueva.
Código
d["particion"] = scaffold_split(d, fraccion_prueba=0.2, fraccion_validacion=0.1, semilla=SEMILLA, acíclicos_a="entrenamiento")resumen = []for p in ["entrenamiento", "validacion", "prueba"]: sub = d[d["particion"] == p] reales = sub[sub["andamio"] != SIN_ANDAMIO]["andamio"].value_counts() resumen.append({"partición": p,"n": len(sub),"% del total": round(len(sub)/len(d)*100, 1),"andamios": sub["andamio"].nunique(),"andamio mayor": int(reales.iloc[0]) iflen(reales) else0,"% que ocupa": round(reales.iloc[0]/len(sub)*100, 1) iflen(reales) else0.0,"% BBB+": round(sub["y"].mean()*100, 1), })pd.DataFrame(resumen).set_index("partición")
n
% del total
andamios
andamio mayor
% que ocupa
% BBB+
partición
entrenamiento
5557
71.2
1741
378
6.8
64.0
validacion
749
9.6
498
3
0.4
72.0
prueba
1499
19.2
1390
2
0.1
57.3
3.2 Verificación de fuga
Código
informe = verificar_fuga(d)print(f"andamios que aparecen en más de una partición : {informe['andamios_cruzados']}")print(f"esqueletos que aparecen en más de una partición : {informe['esqueletos_cruzados']}")print(f"\n>>> SIN FUGA: {informe['sin_fuga']}")ifnot informe["sin_fuga"]:print(" ejemplos de andamios:", informe["ejemplos_andamios"])print(" ejemplos de esqueletos:", informe["ejemplos_esqueletos"])
andamios que aparecen en más de una partición   : 0
esqueletos que aparecen en más de una partición : 0

>>> SIN FUGA: True
Verificar el esqueleto de conectividad, y no solo el andamio, es lo que evita que los estereoisómeros de un mismo compuesto se separen entre particiones. El Avance 1 encontró que la morfina aparece ocho veces en B3DB.
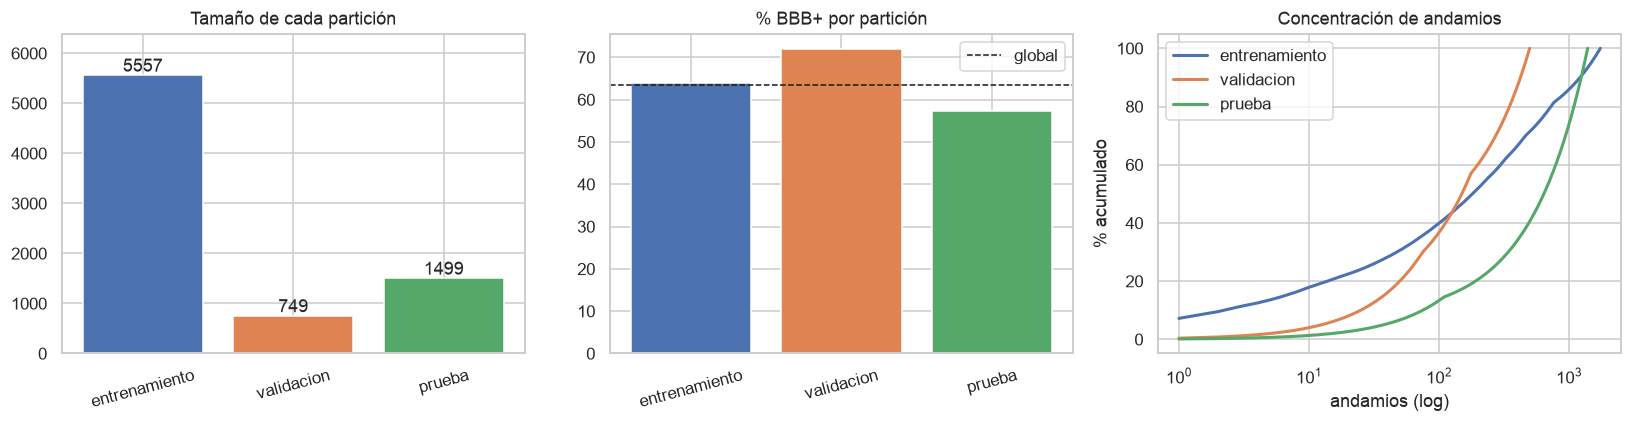
Sobre el desplazamiento de clases: la validación queda más rica en BBB+ que el entrenamiento (72.0% contra 64.0%) y la prueba, más pobre (57.3%). Eso es inherente al scaffold split —se asignan andamios enteros, y los raros no tienen por qué repartirse como los frecuentes— y no se corrige: ajustar la partición para balancear las clases debilitaría justamente lo que la hace una prueba exigente. Se reporta como característica de la evaluación.
Código
fig, axes = plt.subplots(1, 3, figsize=(15, 4))orden = ["entrenamiento", "validacion", "prueba"]t = d["particion"].value_counts().reindex(orden)axes[0].bar(range(3), t.values, color=["#4C72B0", "#DD8452", "#55A868"])axes[0].set_xticks(range(3)); axes[0].set_xticklabels(orden, rotation=15)for i, v inenumerate(t.values): axes[0].text(i, v, str(v), ha="center", va="bottom")axes[0].set_title("Tamaño de cada partición"); axes[0].set_ylim(0, t.max()*1.15)b = d.groupby("particion")["y"].mean().reindex(orden)*100axes[1].bar(range(3), b.values, color=["#4C72B0", "#DD8452", "#55A868"])axes[1].axhline(d["y"].mean()*100, ls="--", c="k", lw=1, label="global")axes[1].set_xticks(range(3)); axes[1].set_xticklabels(orden, rotation=15)axes[1].set_title("% BBB+ por partición"); axes[1].legend()for p, c inzip(orden, ["#4C72B0", "#DD8452", "#55A868"]): sub = d[(d["particion"]==p) & (d["andamio"]!=SIN_ANDAMIO)] vc = sub["andamio"].value_counts() acum = vc.cumsum()/len(sub)*100 axes[2].plot(range(1, len(vc)+1), acum.values, label=p, color=c, lw=2)axes[2].set_xscale("log"); axes[2].set_xlabel("andamios (log)")axes[2].set_ylabel("% acumulado"); axes[2].set_title("Concentración de andamios")axes[2].legend()plt.tight_layout(); plt.show()
La tercera gráfica es la que justifica la dirección de la asignación: la curva del entrenamiento sube rápido (tiene los andamios frecuentes) mientras las de prueba y validación son casi diagonales, o sea un andamio por compuesto. Esa diagonal es la señal de un conjunto de evaluación estructuralmente diverso.
4. Descriptores fisicoquímicos
Código
import timet0 = time.time()desc = descriptores_rdkit(list(d["mol"]))print(f"{desc.shape[1]} descriptores para {len(desc)} moléculas en {time.time()-t0:.1f}s")# auditoría de calidad antes de usarlosprint("\nauditoría de columnas:")desc_limpio, motivos = limpiar_descriptores(desc)
217 descriptores para 7805 moléculas en 34.3s

auditoría de columnas:
  descartadas por constantes: 5  (SMR_VSA8, SlogP_VSA9, fr_isocyan, fr_isothiocyan…)
  descartadas por con_nan: 8  (BCUT2D_MWHI, BCUT2D_MWLOW, BCUT2D_CHGHI, BCUT2D_CHGLO…)
  descartadas por no_finitas: 8  (BCUT2D_MWHI, BCUT2D_MWLOW, BCUT2D_CHGHI, BCUT2D_CHGLO…)
  descartadas por fuera_de_float32: 1  (Ipc)
  descriptores utilizables: 203 de 217
El criterio que importa en la práctica es el cuarto. Ipc, el índice de contenido de información de RDKit, alcanza valores del orden de 1e41 en moléculas grandes: finitos en float64, pero por encima del máximo de float32 (~3.4e38). Random Forest convierte internamente a float32 y falla con “Input X contains infinity or a value too large for dtype(‘float32’)”.
Es un desbordamiento conocido de ese descriptor y no lo detecta un chequeo de isfinite. Aquí costó una ejecución fallida encontrarlo.
Código
# pares muy correlacionados: informativo, no se eliminan todavíacorr = desc_limpio.corr().abs()triangulo = corr.where(np.triu(np.ones(corr.shape), k=1).astype(bool))muy_corr = (triangulo >0.95).sum().sum()print(f"pares con |r| > 0.95: {muy_corr}")print("\nlos descriptores clave para BBB siguen presentes:", [c for c in DESCRIPTORES_CLAVE if c in desc_limpio.columns])print("descriptores utilizables:", desc_limpio.shape[1])
pares con |r| > 0.95: 120

los descriptores clave para BBB siguen presentes: ['TPSA', 'NumHDonors', 'MolLogP', 'MolWt', 'NumHAcceptors']
descriptores utilizables: 203
4.1 El umbral de TPSA, rederivado sobre entrenamiento
El Avance 1 mostró que el umbral óptimo de TPSA se mueve según el subconjunto: 66.6 Ų en el grupo A, 83.6 en A+B, 101.9 en el conjunto completo. La cifra de 66.8 Ų de la literatura no es una constante de la barrera.
Aquí se deriva solo del entrenamiento. Calcularlo sobre todo el conjunto filtraría información de la prueba, y ese umbral es el que después se usará para verificar las explicaciones del modelo.
Código
d = pd.concat([d, desc_limpio[[c for c in DESCRIPTORES_CLAVE if c in desc_limpio.columns]]], axis=1)tr = d["particion"] =="entrenamiento"va = d["particion"] =="validacion"# la prueba no se mira: este AUC informa decisionesfilas = []for col, mayor_positivo in [("TPSA", False), ("NumHDonors", False), ("NumHAcceptors", False), ("MolLogP", True), ("MolWt", False)]:if col notin d.columns:continue u_tr, auc_tr = umbral_youden(d.loc[tr, "y"].values, d.loc[tr, col].values, mayor_positivo) _, auc_va = umbral_youden(d.loc[va, "y"].values, d.loc[va, col].values, mayor_positivo) filas.append({"descriptor": col, "umbral (entrenamiento)": round(u_tr, 1),"AUC entrenamiento": round(auc_tr, 3), "AUC validación": round(auc_va, 3)})tabla = pd.DataFrame(filas).set_index("descriptor")tabla["publicado (n=1058)"] = pd.Series({"TPSA": 0.746, "NumHDonors": 0.699,"NumHAcceptors": 0.673, "MolLogP": 0.617, "MolWt": 0.583})tabla
umbral (entrenamiento)
AUC entrenamiento
AUC validación
publicado (n=1058)
descriptor
TPSA
107.0
0.844
0.828
0.746
NumHDonors
2.0
0.822
0.765
0.699
NumHAcceptors
6.0
0.795
0.742
0.673
MolLogP
1.5
0.744
0.594
0.617
MolWt
434.9
0.713
0.743
0.583
La caída del AUC entre entrenamiento y fuera de entrenamiento es la primera medida honesta de cuánto cuesta el scaffold split. Si un descriptor cae mucho, su poder discriminante dependía de los andamios frecuentes.
5. Fingerprints
Código
mols =list(d["mol"])t0 = time.time()X_morgan = morgan_plegado(mols, radio=2, n_bits=2048) # radio=2 es ECFP4print(f"Morgan/ECFP4 plegado : {X_morgan.shape} en {time.time()-t0:.1f}s")print(f" densidad : {X_morgan.mean()*100:.2f}% de bits activos")print(f" bits activos por mol : mediana {np.median(X_morgan.sum(1)):.0f}, rango [{X_morgan.sum(1).min()}, {X_morgan.sum(1).max()}]")print(f" bits nunca activos : {(X_morgan.sum(0)==0).sum()} de {X_morgan.shape[1]}")
Morgan/ECFP4 plegado : (7805, 2048) en 0.2s
  densidad             : 2.33% de bits activos
  bits activos por mol : mediana 47, rango [1, 142]
  bits nunca activos   : 0 de 2048
5.1 Sort & Slice: fingerprint libre de colisiones
El plegado por hash hace que substructuras químicamente distintas compartan bit, lo que corrompe la atribución por SHAP: el modelo se ve forzado a asignar un valor único a fragmentos con efectos opuestos.
Sort & Slice ordena las substructuras por frecuencia y conserva las más frecuentes, de modo que cada columna corresponde a una sola substructura. El vocabulario se aprende solo del entrenamiento.
Se prefiere sobre CF-MF, la alternativa más reciente, porque CF-MF se validó únicamente con particiones aleatorias —lo admiten sus autores—, su paquete está en estado alfa y su adopción es casi nula. Ver 03-explicabilidad.
La diferencia de cobertura entre entrenamiento y prueba es un indicador directo de dominio de aplicabilidad: mide qué fracción de las substructuras de la prueba el vocabulario reconoce. Una caída grande anticipa que el modelo está extrapolando.
Código
# comparación de tamaños de vocabulario, para elegir n_bits con datosfilas = []for n in [512, 1024, 2048, 4096]: s = SortAndSlice(radio=2, n_bits=n).fit(mols_tr) filas.append({"n_bits": n,"vocabulario": len(s.vocabulario),"cobertura entrenamiento %": round(s.cobertura(mols_tr)*100, 1),"cobertura prueba %": round(s.cobertura(list(d.loc[d.particion=='prueba','mol']))*100, 1)})pd.DataFrame(filas).set_index("n_bits")
vocabulario
cobertura entrenamiento %
cobertura prueba %
n_bits
512
512
67.0
53.4
1024
1024
76.8
61.2
2048
2048
84.8
68.0
4096
4096
91.9
74.1
Esa tabla solo mide cobertura, y la cobertura sube con L por construcción. Para saber si 2048 es suficiente hay que medir desempeño. scripts/experimento_L_sortslice.py lo hace con validación cruzada de 5 pliegues agrupada por andamio y esqueleto de conectividad (los acíclicos, solo por esqueleto, para que los estereoisómeros de un compuesto no se separen), 3 semillas, el vocabulario reaprendido dentro de cada pliegue, tres modelos con hiperparámetros fijos y la prueba sin tocar. Sus resultados se guardan en notebooks/datos/resultados_L_sortslice.csv, que la celda siguiente lee, de modo que la comparación se ve sin volver a correrla.
Un detalle sobre el espacio: todos los compuestos tienen el mismo vector de L columnas; lo que cambia es cuáles valen 1. El entrenamiento tiene 11,475 subestructuras distintas, así que hay de sobra para llenar 2048, que conserva el 18% del vocabulario.
Código
# La tabla de arriba solo mide cobertura, y la cobertura sube con L por construcción.# Esta celda lee la comparación de desempeño que produce# scripts/experimento_L_sortslice.py: validación cruzada de 5 pliegues agrupada por# andamio y esqueleto, 3 semillas, vocabulario reaprendido en cada pliegue, tres modelos# con hiperparámetros fijos. La prueba no se toca.res = pd.read_csv(RAIZ /"notebooks/datos/resultados_L_sortslice.csv")cv = res[res["eval"] =="cv"]cob = res[res["eval"] =="cov"].set_index("L")print(f"subestructuras distintas en el entrenamiento: {int(cob['vocabulario_total'].iloc[0])}\n")print("MCC medio (15 evaluaciones por celda)")print(cv.groupby(["modelo", "L"])["MCC"].mean().unstack("L").round(3).to_string())print("\ndesviación del MCC entre pliegues")print(cv.groupby(["modelo", "L"])["MCC"].std().unstack("L").round(3).to_string())def menor_L(sub, metrica):"""El menor L cuya diferencia con el mejor no supera un error estándar. Las 15 evaluaciones (3 semillas x 5 pliegues) no son independientes: comparten datos de entrenamiento. Por eso el error estándar se corrige como proponen Nadeau y Bengio (2003): varianza x (1/n + n_prueba/n_entrenamiento), con n_prueba/n_entrenamiento = 1/4 en 5 pliegues. Sin la corrección sería ~2 veces más estrecho y sesgaría la elección hacia L grandes. """ pf = sub.groupby(["L", "seed", "fold"])[metrica].mean().unstack("L") n =len(pf) mejor = pf.mean().idxmax() dif =lambda L: pf[mejor] - pf[L] dentro = [L for L in pf.columns if dif(L).mean() <= dif(L).std() * np.sqrt(1/ n +0.25)]return mejor, min(dentro)print("\nmenor L dentro del ruido del mejor (error estándar corregido)")for nombre, sub in [("promedio de los tres", cv)] + [(m, cv[cv["modelo"] == m]) for m in ["LogReg", "RF", "XGB"]]:for met in ["MCC", "AUPRC_neg"]: mejor, elegido = menor_L(sub, met)print(f" {nombre:<20}{met:<10} mejor L = {mejor:<5} menor L dentro del ruido = {elegido}")
subestructuras distintas en el entrenamiento: 11475

MCC medio (15 evaluaciones por celda)
L        64     128    256    512    1024   2048   4096
modelo
LogReg  0.642  0.653  0.654  0.656  0.666  0.669  0.670
RF      0.664  0.680  0.671  0.673  0.678  0.677  0.691
XGB     0.656  0.662  0.655  0.662  0.664  0.662  0.674

desviación del MCC entre pliegues
L        64     128    256    512    1024   2048   4096
modelo
LogReg  0.091  0.090  0.103  0.104  0.105  0.109  0.104
RF      0.093  0.092  0.092  0.097  0.102  0.108  0.094
XGB     0.090  0.094  0.100  0.101  0.106  0.113  0.109

menor L dentro del ruido del mejor (error estándar corregido)
  promedio de los tres MCC        mejor L = 4096  menor L dentro del ruido = 4096
  promedio de los tres AUPRC_neg  mejor L = 4096  menor L dentro del ruido = 4096
  LogReg               MCC        mejor L = 4096  menor L dentro del ruido = 128
  LogReg               AUPRC_neg  mejor L = 4096  menor L dentro del ruido = 2048
  RF                   MCC        mejor L = 4096  menor L dentro del ruido = 128
  RF                   AUPRC_neg  mejor L = 4096  menor L dentro del ruido = 2048
  XGB                  MCC        mejor L = 4096  menor L dentro del ruido = 64
  XGB                  AUPRC_neg  mejor L = 4096  menor L dentro del ruido = 4096
Lo que dice la medición. El desempeño sube despacio con L en los tres modelos y el mejor tamaño medido es 4096 en todos, pero las diferencias son pequeñas frente a la desviación entre pliegues (~0.09 a 0.11 de MCC). Pasar de 2048 a 4096 cambia el MCC en +0.001 (regresión logística), +0.014 (Random Forest) y +0.012 (XGBoost), y el AUPRC sobre BBB− en +0.002, +0.004 y +0.006, a cambio de duplicar las columnas. Con el error estándar corregido, en MCC y por modelo casi cualquier L desde 128 queda a un error estándar del mejor: la medición no distingue tamaños; solo el promedio de los tres modelos señala 4096 por poco (0.009 contra un error estándar de 0.007). En AUPRC, que es la métrica que más se parece al uso final (ordenar candidatos), el menor L dentro del ruido es 2048 para la regresión logística y para Random Forest, y 4096 para XGBoost. No se probó más allá de 4096, y la tendencia no se ha aplanado.
Decisión de trabajo (propuesta, no ratificada). Se conserva L = 2048 como compromiso: es el menor tamaño que el AUPRC no distingue del mejor en dos de los tres modelos, y 4096 es la alternativa si el número de columnas no importa. Como posibilidad, con XGBoost L = 512 da el mismo MCC que 2048 (0.662 en los dos) con una cuarta parte de las columnas por explicar, a cambio de bajar la cobertura de 84.8% a 67.0% en entrenamiento; con Random Forest cuesta 0.004 y con la regresión logística 0.013. Se decide en el Avance 3 con los modelos ya afinados. Límites de esta medición: hiperparámetros sin afinar y una sola partición base. Ver la decisión 1.7 del registro.
5.2 De bit a substructura: el mecanismo de explicabilidad
Código
# se toma un compuesto del entrenamiento y se decodifican algunos de sus bitsi =int(d.index[tr][0])mol = d.loc[i, "mol"]activos = np.flatnonzero(X_morgan[d.index.get_loc(i)])print(f"compuesto: {d.loc[i, 'compound_name']} ({d.loc[i, 'BBB+/BBB-']})")print(f"bits activos: {len(activos)}\n")for bit in activos[:8]:print(f" bit {bit:>4} -> {substructura_de_bit(mol, int(bit))}")
compuesto: hydromorphinol  (BBB+)
bits activos: 47

  bit  211 -> [C@][C@H]([C@@H])Oc(c)c
  bit  231 -> [C@@H]Cc
  bit  311 -> [C@]c(c)c(cc)C[C@@H]
  bit  327 -> [C@@H][C@](C)(c)[C@@](O)(CC)[C@@H](C)N
  bit  389 -> [C@@][C@]([C@@H])(c)CCN
  bit  486 -> [C@@H]N(C)C
  bit  497 -> [C@][C@H]([C@@H])O
  bit  573 -> [C@][C@@H](O)[C@@H](O)CC
Esto es lo que hace verificable la explicabilidad: un bit con peso SHAP alto se traduce en un fragmento químico concreto y dibujable. Es la razón por la que el proyecto usa fingerprints en vez de embeddings densos.
6. Características derivadas del dominio
Los 203 descriptores de RDKit son genéricos: sirven igual para predecir solubilidad que toxicidad. El Avance 1 midió qué gobierna la permeabilidad en este conjunto, y de ahí salen tres características que un descriptor suelto no captura.
Característica
Qué codifica
De dónde sale
regla_2p
cumple TPSA < 67 Ų y HBD ≤ 1
la regla de dos parámetros del Avance 1
tpsa_por_mw
polaridad por unidad de tamaño
TPSA y MW correlacionan 0.64; su cociente separa el efecto
lipo_neta
logP − TPSA/100, el balance entre lipofilicidad y polaridad
cruzar la barrera exige las dos a la vez
La primera es una interacción que ningún modelo lineal encuentra sola; tpsa_por_mw es un cociente y lipo_neta una diferencia de dos columnas existentes, combinaciones que los árboles aproximan con muchos cortes y rara vez bien. Una advertencia que sigue en pie: regla_2p usa el 67 Ų de la literatura, mientras que la sección 4.1 obtiene 107 Ų sobre este conjunto, así que su valor como regla fija está por medir. La otra ya no: las tres sí se comparan con el modelo, con y sin ellas, más abajo en esta misma sección — y el resultado es que no aportan.
Código
nuevas_car = pd.DataFrame(index=desc_limpio.index)nuevas_car["regla_2p"] = ((desc_limpio["TPSA"] <67) & (desc_limpio["NumHDonors"] <=1)).astype(float)nuevas_car["tpsa_por_mw"] = desc_limpio["TPSA"] / desc_limpio["MolWt"]nuevas_car["lipo_neta"] = desc_limpio["MolLogP"] - desc_limpio["TPSA"] /100print("tres características derivadas del dominio:\n")print(nuevas_car.describe().loc[["mean", "50%", "min", "max"]].round(3).to_string())# ¿aportan algo que los descriptores base no tengan ya?from sklearn.metrics import roc_auc_score as _aucprint("\nAUC individual sobre entrenamiento, contra los descriptores base:")itr_ = (d["particion"] =="entrenamiento").valuesfor col in ["regla_2p", "tpsa_por_mw", "lipo_neta"]: v = nuevas_car.loc[itr_, col].values a =max(_auc(d.loc[itr_, "y"], v), _auc(d.loc[itr_, "y"], -v))print(f" {col:14}{a:.3f}")for col in ["TPSA", "MolLogP"]: v = desc_limpio.loc[itr_, col].values a =max(_auc(d.loc[itr_, "y"], v), _auc(d.loc[itr_, "y"], -v))print(f" {col:14}{a:.3f} (base, para comparar)")# correlación con lo que ya existe: si es casi 1, no aportan nada nuevoprint("\nmáxima correlación de cada una con los 203 descriptores base:")for col in nuevas_car.columns: r = desc_limpio.corrwith(nuevas_car[col]).abs().max() quien = desc_limpio.corrwith(nuevas_car[col]).abs().idxmax()print(f" {col:14}{r:.3f} con {quien}")
tres características derivadas del dominio:

      regla_2p  tpsa_por_mw  lipo_neta
mean     0.384        0.220      1.486
50%      0.000        0.204      1.779
min      0.000        0.000    -12.426
max      1.000        1.749     12.606

AUC individual sobre entrenamiento, contra los descriptores base:
  regla_2p       0.684
  tpsa_por_mw    0.810
  lipo_neta      0.795
  TPSA           0.844   (base, para comparar)
  MolLogP        0.744   (base, para comparar)

máxima correlación de cada una con los 203 descriptores base:
  regla_2p       0.602 con TPSA
  tpsa_por_mw    0.755 con MolLogP
  lipo_neta      0.975 con MolLogP
Código
# La produce scripts/experimento_derivadas.py: validación cruzada de 5 pliegues# agrupada por andamio y esqueleto, 3 semillas, solo sobre entrenamiento. Aquí solo se lee.from scipy import statsder = pd.read_csv(RAIZ /"notebooks/datos/resultados_derivadas.csv")orden_der = ["sin derivadas", "las tres", "solo regla_2p", "solo tpsa_por_mw", "solo lipo_neta"]for met, etiqueta in [("MCC", "MCC"), ("AUPRC_neg", "AUPRC sobre BBB−"), ("AUROC", "AUROC")]: t = der.pivot_table(index="conjunto", columns="modelo", values=met).reindex(orden_der)print(f"{etiqueta} medio · 15 evaluaciones por celda")print(t.round(3).to_string(), "\n")print("diferencia contra «sin derivadas», pareada por pliegue (IC 95% con error estándar corregido)")for mod in ["LogReg", "RF"]:for met in ["MCC", "AUROC"]: p = der[der.modelo == mod].pivot_table(index=["seed", "fold"], columns="conjunto", values=met) n =len(p); t95 = stats.t.ppf(0.975, n -1)print(f"\n{mod} · {met}")for conj in orden_der[1:]: dif = p[conj] - p["sin derivadas"] ee = dif.std() * np.sqrt(1/ n +0.25)print(f" {conj:<18}{dif.mean():+.4f} IC95% [{dif.mean() - t95*ee:+.4f}, {dif.mean() + t95*ee:+.4f}]"f" mejora en {int((dif >0).sum())}/{n} pliegues")
MCC medio · 15 evaluaciones por celda
modelo            LogReg     RF
conjunto
sin derivadas      0.695  0.710
las tres           0.695  0.704
solo regla_2p      0.695  0.705
solo tpsa_por_mw   0.695  0.711
solo lipo_neta     0.695  0.705

AUPRC sobre BBB− medio · 15 evaluaciones por celda
modelo            LogReg     RF
conjunto
sin derivadas      0.878  0.900
las tres           0.877  0.901
solo regla_2p      0.877  0.900
solo tpsa_por_mw   0.878  0.901
solo lipo_neta     0.878  0.899

AUROC medio · 15 evaluaciones por celda
modelo            LogReg     RF
conjunto
sin derivadas      0.912  0.933
las tres           0.912  0.933
solo regla_2p      0.912  0.933
solo tpsa_por_mw   0.912  0.933
solo lipo_neta     0.912  0.932

diferencia contra «sin derivadas», pareada por pliegue (IC 95% con error estándar corregido)

  LogReg · MCC
    las tres           +0.0001  IC95% [-0.0066, +0.0067]  mejora en 6/15 pliegues
    solo regla_2p      -0.0003  IC95% [-0.0089, +0.0083]  mejora en 6/15 pliegues
    solo tpsa_por_mw   +0.0004  IC95% [-0.0023, +0.0031]  mejora en 5/15 pliegues
    solo lipo_neta     -0.0004  IC95% [-0.0042, +0.0034]  mejora en 3/15 pliegues

  LogReg · AUROC
    las tres           -0.0002  IC95% [-0.0008, +0.0005]  mejora en 6/15 pliegues
    solo regla_2p      -0.0003  IC95% [-0.0010, +0.0004]  mejora en 4/15 pliegues
    solo tpsa_por_mw   -0.0001  IC95% [-0.0004, +0.0003]  mejora en 6/15 pliegues
    solo lipo_neta     +0.0002  IC95% [-0.0002, +0.0005]  mejora en 10/15 pliegues

  RF · MCC
    las tres           -0.0062  IC95% [-0.0246, +0.0122]  mejora en 6/15 pliegues
    solo regla_2p      -0.0050  IC95% [-0.0206, +0.0105]  mejora en 7/15 pliegues
    solo tpsa_por_mw   +0.0009  IC95% [-0.0149, +0.0166]  mejora en 10/15 pliegues
    solo lipo_neta     -0.0042  IC95% [-0.0228, +0.0143]  mejora en 6/15 pliegues

  RF · AUROC
    las tres           +0.0004  IC95% [-0.0021, +0.0029]  mejora en 9/15 pliegues
    solo regla_2p      +0.0005  IC95% [-0.0025, +0.0036]  mejora en 7/15 pliegues
    solo tpsa_por_mw   +0.0003  IC95% [-0.0025, +0.0031]  mejora en 10/15 pliegues
    solo lipo_neta     -0.0004  IC95% [-0.0037, +0.0029]  mejora en 7/15 pliegues
Las tres entran al filtrado, y ninguna mejora el modelo.
El Avance 2 las justificó con su AUC individual y su correlación. La revisión del Avance 2 señaló que eso no contesta la pregunta: un AUC individual alto no dice si la variable añade algo a un modelo que ya tiene los 203 descriptores. Así que se midió con el modelo, con la misma validación cruzada agrupada, con y sin ellas (scripts/experimento_derivadas.py).
Diferencia pareada por pliegue de MCC contra no usarlas, 15 evaluaciones:
Modelo
Conjunto
ΔMCC
Gana en
Regresión logística
las tres
+0.0001 ± 0.0014
6 de 15
Random Forest
las tres
−0.0062 ± 0.0039
6 de 15
Random Forest
solo tpsa_por_mw
+0.0009 ± 0.0034
10 de 15
Con la logística no se mueve nada: las cuatro variantes caen dentro de dos milésimas. Con Random Forest, las tres juntas quedan por debajo de no usarlas, aunque dentro de un par de errores estándar. La única con asomo de señal es tpsa_por_mw, que gana en 10 de 15 pliegues con una diferencia de nueve diezmilésimas: ruido.
Las tres se conservan en la matriz —quitarlas tampoco mejora— pero la justificación cambia: están porque son interpretables y baratas, no porque aporten desempeño medido. Cualquier afirmación de que «aportan» necesita esta tabla al lado.
AUC individual
Correlación máxima
Qué pasa en el filtrado
tpsa_por_mw
0.810
0.755 con MolLogP
sobrevive
lipo_neta
0.795
0.975 con MolLogP
no sobrevive
regla_2p
0.684
0.602 con TPSA
sobrevive
lipo_neta cambió de destino con la selección nueva. Antes desplazaba a MolLogP, que tenía un F de ANOVA menor; ahora MolLogP está protegida —junto con TPSA, donadores, aceptores y el peso molecular— porque dejar fuera un descriptor con significado químico a favor de una derivada degrada la explicabilidad, que es un requisito del proyecto y no una preferencia. Entre dos columnas que correlacionan 0.975, se queda la que se puede explicar.
regla_2p sigue abierta por otra razón: su umbral de 67 Ų viene de la literatura, y la sección 4.1 obtiene 107 Ų sobre estos datos. Derivarlo del entrenamiento o retirar la variable es el punto 3c de la revisión, pendiente.
7. Codificación de las variables categóricas
Antes de escalar hay que decidir qué pasa con las dos columnas que no son numéricas y que sí describen al compuesto: group, la categoría A–D de B3DB, y natural, el cruce con COCONUT.
Código
cats = pd.get_dummies(d[["group", "natural"]].astype(str), prefix=["grupo", "natural"], dtype=float)print("codificación one-hot de las dos categóricas:")print(cats.sum().astype(int).to_string())print(f"\ncardinalidad: group = {d['group'].nunique()} · natural = {d['natural'].nunique()}")print("\nAmbas son de cardinalidad baja, así que one-hot no infla la matriz:")print(f" {cats.shape[1]} columnas nuevas sobre {desc_limpio.shape[1]} descriptores")
codificación one-hot de las dos categóricas:
grupo_A          1058
grupo_B          3621
grupo_C          3075
grupo_D            51
natural_False    4439
natural_True     3366

cardinalidad: group = 4 · natural = 2

Ambas son de cardinalidad baja, así que one-hot no infla la matriz:
  6 columnas nuevas sobre 203 descriptores
Se codifican, pero no entran al modelo. La decisión 1.1 del registro fija que group se usa para estratificar y describir, nunca como predictor: está confundida con la etiqueta, así que un modelo que la reciba aprende el sesgo de curación de B3DB en vez de la química.
Con natural pasa algo parecido pero por otra razón: es el eje sobre el que hay que reportar el desempeño por separado, y meterla como variable haría que el modelo la use para compensar en vez de dejar ver la brecha.
Las dos viajan en los metadatos. La codificación queda hecha y justificada aquí por si el Avance 3 decide usarlas en un brazo de robustez.
8. Normalización
La rúbrica pide escalar y, si hace falta, transformar para acercar las distribuciones a la normal. Las dos decisiones se miden, no se afirman.
Y las dos tienen una alternativa que no se descarta: no escalar. Los modelos de árboles previstos son invariantes a transformaciones monótonas de cada variable, así que para ellos escalar no cambia nada —los números de la 8.2 lo confirman, en desempeño y en tiempo—. Para la regresión logística sí cambia, y lo que cambia no es el acierto sino la convergencia: la 8.2 lo mide. Así que se escala para ella, no se escala para los árboles, y la matriz sin transformar se guarda junto a la transformada para que la decisión siga siendo reversible.
Código
from scipy.stats import skew# las tres de dominio entran con el resto y pasan por los mismos filtrosdesc_ext = pd.concat([desc_limpio, nuevas_car], axis=1)X_desc = desc_ext.values.astype(float)asimetria = pd.Series(skew(X_desc, axis=0, nan_policy="omit"), index=desc_ext.columns)print("Asimetría de los 203 descriptores:")print(f" |sesgo| > 2 (muy asimétricos): {(asimetria.abs() >2).sum()}")print(f" |sesgo| > 1 : {(asimetria.abs() >1).sum()}")print(f" |sesgo| <= 0.5 (casi simétricos): {(asimetria.abs() <=0.5).sum()}")print("\nlos cinco más asimétricos:")print(asimetria.abs().nlargest(5).round(1).to_string())print("\nRangos, que es lo que obliga a escalar:")rangos = pd.DataFrame({"min": desc_limpio.min(), "max": desc_limpio.max()})rangos["amplitud"] = rangos["max"] - rangos["min"]print(rangos["amplitud"].describe()[["min", "50%", "max"]].round(1).to_string())print(f"\n el descriptor de mayor amplitud ({rangos['amplitud'].idxmax()}) abarca {rangos['amplitud'].max():,.0f}")print(f" el de menor ({rangos['amplitud'].idxmin()}) abarca {rangos['amplitud'].min():.2f}")
Asimetría de los 203 descriptores:
  |sesgo| > 2 (muy asimétricos): 131
  |sesgo| > 1                  : 182
  |sesgo| <= 0.5 (casi simétricos): 7

los cinco más asimétricos:
fr_diazo               88.3
Kappa3                 70.5
NumRadicalElectrons    42.5
fr_azo                 39.5
fr_phos_acid           30.3

Rangos, que es lo que obliga a escalar:
min        0.5
50%       16.0
max    18795.5

  el descriptor de mayor amplitud (Kappa3) abarca 18,796
  el de menor (MinAbsPartialCharge) abarca 0.51
La amplitud va de menos de una unidad a varios miles. Un modelo lineal o basado en distancias trataría al descriptor grande como si pesara miles de veces más, no por su contenido sino por sus unidades.
8.1 Qué transformación, medida sobre entrenamiento
Se comparan tres: estandarización (media 0, desviación 1), min–max a [0,1] y Yeo-Johnson, que es la que puede acercar a la normal. De las que acercan a la normal se prueba Yeo-Johnson y no Box-Cox ni logaritmo porque muchos descriptores valen cero o negativo y esas dos exigen valores estrictamente positivos. Cuál conviene no se decide en esta sección: corregir la asimetría y predecir mejor resultan ser cosas distintas, y eso lo mide la 8.2.
log1p sí serviría para el subconjunto de conteos no negativos —los fr_* de grupos funcionales—, pero exigiría aplicar dos transformaciones distintas según la columna y Yeo-Johnson ya cubre ambos casos con una sola.
Todas se ajustan solo con entrenamiento, igual que el vocabulario de Sort & Slice.
Código
from sklearn.preprocessing import StandardScaler, MinMaxScaler, PowerTransformer# Las decisiones de esta sección y de la 8 se toman mirando SOLO validación.# Usar validación + prueba contaminaría la prueba: se estaría eligiendo el# método que mejor le va al conjunto que después se usa para reportar.idx_tr = np.where((d["particion"] =="entrenamiento").values)[0]idx_va = np.where((d["particion"] =="validacion").values)[0]Xtr, Xva = X_desc[idx_tr], X_desc[idx_va]yva = d.iloc[idx_va]["y"].valuesprint(f"entrenamiento {len(idx_tr):,} · validación {len(idx_va):,} (la prueba no se toca aquí)\n")print(f"con valores <= 0: {(desc_limpio.min() <=0).sum()} de {desc_limpio.shape[1]} descriptores")print("por eso se descarta Box-Cox y el logaritmo, que exigen valores positivos\n")transformadores = {"sin escalar": None,"estandarización": StandardScaler(),"min-max": MinMaxScaler(),"Yeo-Johnson": PowerTransformer(method="yeo-johnson", standardize=True),}versiones, filas = {}, []for nombre, t in transformadores.items():if t isNone: a, b = Xtr, Xvaelse: a = t.fit_transform(Xtr) # ajustado SOLO con entrenamiento b = t.transform(Xva) versiones[nombre] = (a, b) s = np.abs(skew(a, axis=0, nan_policy="omit")) s = s[np.isfinite(s)] # una columna constante tras transformar da NaN filas.append({"transformación": nombre,"|sesgo| mediano": round(float(np.median(s)), 2),"muy asimétricos (>2)": int((s >2).sum()),"amplitud mediana": round(float(np.median(a.max(0) - a.min(0))), 1)})print(pd.DataFrame(filas).to_string(index=False))
entrenamiento 5,557 · validación 749 (la prueba no se toca aquí)

con valores <= 0: 193 de 203 descriptores
por eso se descarta Box-Cox y el logaritmo, que exigen valores positivos

 transformación  |sesgo| mediano  muy asimétricos (>2)  amplitud mediana
    sin escalar             2.20                   106              11.0
estandarización             2.20                   106               8.4
        min-max             2.20                   106               1.0
    Yeo-Johnson             0.31                    66               5.2
8.2 El efecto se mide, no se asume
El argumento fácil sería «los modelos de árboles no necesitan escalar». Es cierto para Random Forest, pero el proyecto entrena una regresión logística como modelo interpretable de control, y esa sí es sensible a la escala. Así que la justificación general no vale: hay que medir qué le pasa a cada familia.
Código
ytr = d.iloc[idx_tr]["y"].values# La comparación de una sola corrida que había aquí no decidía: su orden entre# Yeo-Johnson y min–max cambiaba de entorno (0.484 contra 0.497 en macOS con# Python 3.14, 0.484 contra 0.481 en Linux, 0.484 contra 0.489 en macOS con 3.12).# La produce ahora scripts/experimento_escalado.py: validación cruzada de 5# pliegues agrupada por andamio y esqueleto, 3 semillas, la transformación# reajustada DENTRO de cada pliegue y la prueba sin tocar. Aquí solo se lee.from scipy import statsesc = pd.read_csv(RAIZ /"notebooks/datos/resultados_escalado.csv")cv_esc = esc[esc["eval"] =="cv"]orden = ["sin escalar", "estandarización", "min-max", "Yeo-Johnson"]for met, etiqueta in [("MCC", "MCC"), ("AUPRC_neg", "AUPRC sobre BBB−")]: t = cv_esc.pivot_table(index="transformacion", columns="modelo", values=met).reindex(orden)print(f"{etiqueta} medio · 15 evaluaciones por celda (3 semillas x 5 pliegues)")print(t.round(3).to_string(), "\n")# El otro motivo para escalar, y el que la rúbrica del Avance 2 nombra: la convergencia.# No se infiere del tiempo: se miden las iteraciones de lbfgs y si avisó de no converger.lr = cv_esc[cv_esc["modelo"] =="LogReg"]conv = lr.groupby("transformacion").agg( iteraciones=("n_iter", "median"), sin_converger=("sin_converger", "sum"), segundos=("ajuste_s", "median"),).reindex(orden)n_eval = lr["fold"].nunique() * lr["seed"].nunique()conv["segundos"] = conv["segundos"].round(3)conv["iteraciones"] = conv["iteraciones"].astype(int)conv["sin_converger"] = conv["sin_converger"].astype(int).astype(str) +f"/{n_eval}"print("convergencia de la regresión logística (mediana de 15 pliegues, max_iter=3000)")print(conv.to_string(), "\n")print("C que cada transformación elige para sí (mediana de los 15 pliegues)")print(cv_esc[cv_esc["modelo"] =="LogReg-C"].groupby("transformacion")["C"] .agg(["median", "min", "max"]).reindex(orden).to_string(), "\n")print("tiempo de ajuste en segundos, los modelos")print(cv_esc.pivot_table(index="transformacion", columns="modelo", values="ajuste_s", aggfunc="median").reindex(orden).round(3).to_string())print(" el Random Forest no cambia: no itera, así que el escalado no le afecta\n")cond = esc[esc["eval"] =="cond"].set_index("transformacion")["condicion"].reindex(orden)print("número de condición de la matriz de entrenamiento")print(cond.map(lambda v: f"{v:.2e}").to_string())print(" sigue siendo enorme con las cuatro: el mal condicionamiento viene de las columnas")print(" casi colineales (la sección 4 mide 120 pares con |r| > 0.95), y eso lo trata la")print(" sección 9, no el escalado\n")print("desviación del MCC entre evaluaciones")print(cv_esc.pivot_table(index="transformacion", columns="modelo", values="MCC", aggfunc="std").reindex(orden).round(3).to_string())def comparar(metrica, modelo):"""Cada transformación contra la mejor: diferencia, error estándar e intervalo. Mismo criterio que la sección 5.1: las 15 evaluaciones comparten datos de entrenamiento, así que no son independientes y el error estándar se corrige como proponen Nadeau y Bengio (2003), varianza x (1/n + n_prueba/n_entrenamiento). La diferencia se toma **pareada por pliegue**, que es lo que quita la varianza entre pliegues y deja ver la que viene de la transformación. Se imprime el intervalo de confianza y no un veredicto de «dentro o fuera del ruido». El umbral de un error estándar que usa la sección 5.1 sirve para preguntar *cuál es el L más chico que no se distingue del mejor* —ahí ser laxo es conservador, porque elige el modelo más simple—, pero usado al revés, para afirmar que una diferencia existe, es demasiado permisivo: un error estándar es apenas t = 1 y el intervalo todavía cruza el cero. """ pf = (cv_esc[cv_esc["modelo"] == modelo] .pivot_table(index=["seed", "fold"], columns="transformacion", values=metrica)) n =len(pf) t95 = stats.t.ppf(0.975, n -1) medias = pf.mean().sort_values(ascending=False) mejor = medias.index[0]print(f"\n{modelo} · mejor: {mejor} ({medias[mejor]:.3f})")for t in medias.index[1:]: dif = pf[mejor] - pf[t] ee = dif.std() * np.sqrt(1/ n +0.25) lo, hi = dif.mean() - t95 * ee, dif.mean() + t95 * ee gana =int((dif >0).sum())print(f" contra {t:<16}{dif.mean():+.3f} EE {ee:.3f} t {dif.mean()/ee:4.1f}"f" IC95% [{lo:+.3f}, {hi:+.3f}] gana en {gana}/{n} pliegues")for met in ["MCC", "AUPRC_neg"]:print(f"\ndiferencia contra la mejor transformación, en {met}")for mod in ["LogReg", "LogReg-C", "RF"]: comparar(met, mod)print("\nNingún intervalo excluye el cero: con 15 evaluaciones dependientes la medición""\nno establece que una transformación supere a otra. Lo que sí deja ver es que el""\nRandom Forest es indiferente, con intervalos muy estrechos.""\n\nY que la desventaja de Yeo-Johnson era del C y no de la transformación: con C""\nfijo queda 0.030 por debajo de min-max (12 de 15 pliegues), y con el C que cada""\nuna elige para sí la diferencia es de 0.000. Los C elegidos están a dos órdenes""\nde magnitud de distancia —0.01 contra 1.0—, así que comparar a C fijo compara la""\ntransformación y la regularización a la vez.")print("\n\nla medición anterior, de una sola corrida sobre la validación fija:")print(esc[esc["eval"] =="val"].pivot_table(index="transformacion", columns="modelo", values=["MCC", "AUROC"]).reindex(orden).round(3).to_string())
MCC medio · 15 evaluaciones por celda (3 semillas x 5 pliegues)
modelo           LogReg  LogReg-C     RF
transformacion
sin escalar       0.687       NaN  0.704
estandarización   0.690     0.699  0.705
min-max           0.695     0.695  0.704
Yeo-Johnson       0.665     0.695  0.705

AUPRC sobre BBB− medio · 15 evaluaciones por celda (3 semillas x 5 pliegues)
modelo           LogReg  LogReg-C     RF
transformacion
sin escalar       0.867       NaN  0.901
estandarización   0.864     0.876  0.901
min-max           0.878     0.877  0.901
Yeo-Johnson       0.862     0.874  0.901

convergencia de la regresión logística (mediana de 15 pliegues, max_iter=3000)
                 iteraciones sin_converger  segundos
transformacion
sin escalar             3000         15/15     0.399
estandarización          144          0/15     0.018
min-max                   53          0/15     0.007
Yeo-Johnson              137          0/15     0.016

C que cada transformación elige para sí (mediana de los 15 pliegues)
                 median    min   max
transformacion
sin escalar         NaN    NaN   NaN
estandarización    0.01  0.010  0.01
min-max            1.00  0.100  1.00
Yeo-Johnson        0.01  0.001  0.01

tiempo de ajuste en segundos, los modelos
modelo           LogReg  LogReg-C     RF
transformacion
sin escalar       0.399       NaN  0.237
estandarización   0.018     0.004  0.236
min-max           0.007     0.007  0.230
Yeo-Johnson       0.016     0.004  0.226
  el Random Forest no cambia: no itera, así que el escalado no le afecta

número de condición de la matriz de entrenamiento
transformacion
sin escalar        1.22e+21
estandarización    6.28e+18
min-max            6.20e+19
Yeo-Johnson        5.89e+17
  sigue siendo enorme con las cuatro: el mal condicionamiento viene de las columnas
  casi colineales (la sección 4 mide 120 pares con |r| > 0.95), y eso lo trata la
  sección 9, no el escalado

desviación del MCC entre evaluaciones
modelo           LogReg  LogReg-C     RF
transformacion
sin escalar       0.074       NaN  0.083
estandarización   0.066     0.068  0.081
min-max           0.068     0.068  0.082
Yeo-Johnson       0.077     0.070  0.079

diferencia contra la mejor transformación, en MCC

  LogReg · mejor: min-max (0.695)
    contra estandarización  +0.005  EE 0.012  t  0.4  IC95% [-0.021, +0.032]  gana en 9/15 pliegues
    contra sin escalar      +0.009  EE 0.017  t  0.5  IC95% [-0.028, +0.045]  gana en 8/15 pliegues
    contra Yeo-Johnson      +0.030  EE 0.019  t  1.6  IC95% [-0.010, +0.071]  gana en 12/15 pliegues

  LogReg-C · mejor: estandarización (0.699)
    contra Yeo-Johnson      +0.004  EE 0.007  t  0.5  IC95% [-0.012, +0.020]  gana en 10/15 pliegues
    contra min-max          +0.004  EE 0.007  t  0.5  IC95% [-0.012, +0.020]  gana en 11/15 pliegues

  RF · mejor: estandarización (0.705)
    contra Yeo-Johnson      +0.000  EE 0.006  t  0.0  IC95% [-0.012, +0.012]  gana en 7/15 pliegues
    contra min-max          +0.000  EE 0.006  t  0.1  IC95% [-0.013, +0.013]  gana en 7/15 pliegues
    contra sin escalar      +0.001  EE 0.006  t  0.2  IC95% [-0.011, +0.014]  gana en 8/15 pliegues

diferencia contra la mejor transformación, en AUPRC_neg

  LogReg · mejor: min-max (0.878)
    contra sin escalar      +0.011  EE 0.007  t  1.7  IC95% [-0.003, +0.026]  gana en 13/15 pliegues
    contra estandarización  +0.014  EE 0.009  t  1.6  IC95% [-0.005, +0.033]  gana en 11/15 pliegues
    contra Yeo-Johnson      +0.017  EE 0.012  t  1.4  IC95% [-0.009, +0.043]  gana en 13/15 pliegues

  LogReg-C · mejor: min-max (0.877)
    contra estandarización  +0.001  EE 0.004  t  0.3  IC95% [-0.008, +0.011]  gana en 8/15 pliegues
    contra Yeo-Johnson      +0.004  EE 0.005  t  0.7  IC95% [-0.007, +0.014]  gana en 9/15 pliegues

  RF · mejor: estandarización (0.901)
    contra min-max          +0.000  EE 0.001  t  0.0  IC95% [-0.002, +0.002]  gana en 6/15 pliegues
    contra sin escalar      +0.000  EE 0.001  t  0.2  IC95% [-0.002, +0.002]  gana en 6/15 pliegues
    contra Yeo-Johnson      +0.000  EE 0.002  t  0.2  IC95% [-0.004, +0.005]  gana en 8/15 pliegues

Ningún intervalo excluye el cero: con 15 evaluaciones dependientes la medición
no establece que una transformación supere a otra. Lo que sí deja ver es que el
Random Forest es indiferente, con intervalos muy estrechos.

Y que la desventaja de Yeo-Johnson era del C y no de la transformación: con C
fijo queda 0.030 por debajo de min-max (12 de 15 pliegues), y con el C que cada
una elige para sí la diferencia es de 0.000. Los C elegidos están a dos órdenes
de magnitud de distancia —0.01 contra 1.0—, así que comparar a C fijo compara la
transformación y la regularización a la vez.


la medición anterior, de una sola corrida sobre la validación fija:
                 AUROC                    MCC
modelo          LogReg LogReg-C     RF LogReg LogReg-C     RF
transformacion
sin escalar      0.799      NaN  0.916  0.430      NaN  0.566
estandarización  0.814    0.842  0.917  0.451    0.484  0.567
min-max          0.831    0.831  0.916  0.489    0.489  0.562
Yeo-Johnson      0.823    0.850  0.920  0.484    0.495  0.589
Lo que dicen los números, y hasta dónde llegan. Con validación cruzada se puede poner un intervalo alrededor de cada diferencia, y la primera conclusión es sobre el tamaño de ese intervalo: ningún intervalo del 95% excluye el cero. Con quince evaluaciones que comparten datos de entrenamiento, la medición no establece que una transformación supere a otra. La diferencia mayor, min–max contra Yeo-Johnson en la regresión logística con el mismo C para las cuatro, es de 0.030 de MCC con un error estándar corregido de 0.019: t = 1.6, intervalo [−0.010, +0.071]. Con el C propio de cada transformación esa diferencia es de 0.000, y la mayor pasa a ser de 0.004.
Y hay una fila de esa tabla que no se puede leer como las demás: sin escalar, la regresión logística no converge. Agota las 3,000 iteraciones de lbfgs en los 15 pliegues y avisa de que no convergió en los 15. Con cualquiera de las tres transformaciones converge sin aviso, en 53 iteraciones con min–max y 137 a 144 con las otras dos. Así que el 0.687 de MCC de la fila «sin escalar» no es el desempeño de ese enfoque: es donde se quedó el optimizador cuando se le acabó el presupuesto, y no es comparable con el resto.
Eso es lo que justifica escalar, y es justo lo que la rúbrica de esta fase pide al nombrar la convergencia. El tiempo —0.399 s contra 0.007 s— es la consecuencia visible, no la prueba; las iteraciones y el aviso son la prueba. El Random Forest es el control que cierra el argumento: tarda lo mismo con las cuatro, porque no itera y solo mira el orden de los valores, así que no es que los datos sean «más difíciles» sin escalar.
La magnitud del tiempo depende de la máquina y la dirección no: en Linux, sobre el experimento completo, la misma comparación dio 1,110 s contra 40 s. Las iteraciones y el aviso, en cambio, no dependen de la máquina: son una propiedad del problema.
Lo que el escalado no arregla. El número de condición de la matriz es astronómico con las cuatro transformaciones, de 5.9e+17 a 1.2e+21: escalar lo baja algún orden de magnitud pero no lo resuelve, porque viene de columnas casi colineales —la sección 4 mide 120 pares con |r| > 0.95— y eso lo trata la selección de la sección 9, no el escalado. Conviene no atribuirle al escalado un problema que no toca.
Eso no vuelve inútil la comparación de desempeño, porque sí separa dos cosas:
En Random Forest la transformación es irrelevante, y esto sí queda establecido: las diferencias son de 0.000 a 0.001 con intervalos de ±0.002 a ±0.005. El intervalo es tan estrecho que descarta cualquier efecto que importe. La invariancia de los árboles a transformaciones monótonas de cada variable deja de ser solo un argumento.
Lo que parecía una desventaja de Yeo-Johnson era del C. Con el mismo C = 1 para las cuatro, Yeo-Johnson queda 0.030 de MCC por debajo de min–max y pierde en 12 de los 15 pliegues. Con el C que cada transformación elige para sí por validación cruzada interna (la columna LogReg-C), las dos empatan en 0.695 y la mejor pasa a ser estandarización por 0.004, que es t = 0.5. La medición no distingue entre las tres.
Y se ve por qué comparar a C fijo no era comparar la transformación. Los C elegidos están a dos órdenes de magnitud de distancia: 0.01 con estandarización y con Yeo-Johnson, 1.0 con min–max. Un solo C para las cuatro mide la transformación y la regularización a la vez, y el valor que se había fijado resultó ser justo el que min–max prefiere.
Una nota sobre el umbral. La sección 5.1 usa «a un error estándar del mejor» para elegir el menor L, y ahí ser laxo es conservador: elige el modelo más simple. Usado al revés, para afirmar que una diferencia existe, un error estándar es apenas t = 1 y no basta. Es el mismo número con el riesgo invertido, así que aquí se reportan intervalos y no un veredicto.
Una explicación que había aquí y la medición retiró. Esta sección proponía como hipótesis que la transformación de potencia comprimiera las colas, donde vive parte de la señal, y para apoyarla citaba que comparar Yeo-Johnson con estandarización aísla el paso de potencia —PowerTransformer(standardize=True) es potencia y luego estandarización— y daba +0.025 a favor de estandarización. Con el C propio ese mismo contraste cae a +0.004 (t = 0.5): no había efecto que explicar. La hipótesis no era falsa, era innecesaria, y es el modo de fallar que este proyecto ya conoce — construir una explicación sobre un número antes de comprobar que el número mide lo que parece.
Queda el hecho, sin consecuencia medida: Yeo-Johnson es la que mejor corrige la asimetría, de 106 a 66 descriptores muy asimétricos, y eso no se traduce en mejor predicción con ninguno de los dos modelos.
Por qué hacía falta medirlo así. La última fila de la salida es la medición anterior, de una sola corrida sobre la validación fija, y deja ver el problema: ahí Yeo-Johnson y min–max se alternan según el entorno (0.484 contra 0.489 en este, 0.484 contra 0.481 en Linux, 0.484 contra 0.497 en macOS con Python 3.14). Lo que cambia con la validación cruzada no es que ahora haya un ganador: es que ahora se conoce el tamaño de la incertidumbre, y resulta ser mayor que todas las diferencias entre transformaciones menos una.
Qué se propone, y qué decide la patrocinadora. La decisión de escalar y de reducir dimensión es de la 1.5, que es suya; esto es lo que la medición aporta a esa conversación.
Para los árboles, no escalar, y aquí la medición es concluyente por los dos lados: intervalos de desempeño de ±0.002 y tiempo de ajuste idéntico con las cuatro.
Para la regresión logística, escalar, porque sin escalar no converge. No es una preferencia: la alternativa deja un modelo que agotó sus iteraciones.
Entre las tres formas de escalar no hay base para elegir, y ahora menos que antes: con el C propio de cada una, los MCC son 0.699, 0.695 y 0.695. Min–max converge en menos iteraciones y da el mejor AUPRC, pero 0.878 contra 0.864 queda muy dentro de la desviación entre pliegues, y la diferencia de tiempo son centésimas de segundo. Se toma min–max como opción de partida, no como conclusión.
Ya no hay motivo medido para evitar Yeo-Johnson. Lo había mientras el C era el mismo para todas; con el suyo, la diferencia desaparece. Es la observación de la tutora y resultó estar bien.
Todo esto es propuesta, no decisión: ninguna de las cuatro queda cerrada hasta que la patrocinadora revise la 1.5. La decisión 1.5 del registro sigue siendo una propuesta; esto es lo que aporta a su discusión, y lo que aporta es sobre todo una cota.
La selección ya no depende de la transformación, y eso está medido. La sección 9 elige las 151 columnas sobre los valores crudos: el criterio de casi constancia es el valor modal, que no mira la escala, y el de redundancia es la correlación de Spearman, que solo mira el orden. Antes los dos filtros operaban sobre los valores transformados, así que cambiar la transformación obligaba a repetir la selección; la sección 9 lo comprueba ahora y sale la misma selección con estandarización, con min–max y con Yeo-Johnson. Lo que sigue en pie es la propuesta de escalado: el artefacto bbb_descriptores_filtrados.parquet se guarda transformado con Yeo-Johnson y al lado va la versión sin transformar, con las mismas columnas y en el mismo orden, así que el Avance 3 corre cualquiera de las dos sin recalcular nada. Cerrar cuál se adopta es trabajo del Avance 3, con los modelos afinados y con suficientes evaluaciones para que los intervalos se cierren.
El escalador se guarda ajustado sobre entrenamiento. Aplicarlo a todo el conjunto antes de partir habría filtrado la media y la varianza de la prueba, que es el mismo error que el proyecto evita con el vocabulario de Sort & Slice y con el umbral de TPSA.
9. Selección y extracción de características
Tres métodos de filtrado y uno de extracción, todos ajustados solo con entrenamiento. La sección 4 ya midió que hay 120 pares de descriptores con |r| > 0.95, así que la redundancia está confirmada antes de actuar sobre ella.
Código
from sklearn.feature_selection import mutual_info_classiffrom sklearn.decomposition import PCAfrom features.seleccion import casi_constantes, filtro_correlacion, poder_univariadonombres = np.array(desc_ext.columns)Xcrudo = X_desc[idx_tr] # entrenamiento, sin transformarAtr, Ava = versiones["Yeo-Johnson"] # solo para medir lo que sigue (modelos, PCA)# --- filtro 1: casi constantes, sobre los datos CRUDOS --------------------------keep_var = casi_constantes(Xcrudo, frecuencia_modal=0.99)print(f"1 · casi constantes (un valor reúne ≥ 99% del entrenamiento): "f"se descartan {(~keep_var).sum()}, quedan {keep_var.sum()} de {len(nombres)}")print(f" descartadas: {', '.join(nombres[~keep_var])}")print(f" (el filtro anterior, varianza > 0.01 sobre Yeo-Johnson estandarizado, dejaba "f"{(Atr.var(axis=0) >0.01).sum()} de {len(nombres)}: toda columna tiene varianza 1,"f" así que solo quitaba la constante)")# --- filtro 2: correlación de Spearman, se conserva el de mayor poder univariadosub = nombres[keep_var]Xs = Xcrudo[:, keep_var]poder = poder_univariado(Xs, ytr) # |AUROC − 0.5| de cada columnaprotegidas =tuple(i for i, n inenumerate(sub) if n in DESCRIPTORES_CLAVE)keep_corr = filtro_correlacion(Xs, poder, umbral=0.95, protegidas=protegidas)descartar = np.where(~keep_corr)[0]print(f"2 · correlación de Spearman |ρ|>0.95: se descartan {len(descartar)}, quedan {keep_corr.sum()}")# Spearman y el AUROC solo usan el orden: la selección no cambia con la transformación.for nombre_t in ["estandarización", "min-max", "Yeo-Johnson"]: T = versiones[nombre_t][0][:, keep_var] igual = np.array_equal(keep_corr, filtro_correlacion(T, poder_univariado(T, ytr), 0.95, protegidas))print(f" misma selección sobre {nombre_t:<16}: {igual}")# --- filtro 3: información mutua con la etiqueta ------------------------------sub2 = sub[keep_corr]Btr = Atr[:, keep_var][:, keep_corr]Bva = Ava[:, keep_var][:, keep_corr]mi = mutual_info_classif(Btr, ytr, random_state=42)print(f"3 · información mutua: {(mi <=0).sum()} descriptores no aportan nada sobre la etiqueta")print(f" los cinco de mayor MI: {', '.join(sub2[np.argsort(-mi)[:5]])}")orden = np.argsort(-mi)print(f"\nde {len(nombres)} descriptores a {len(sub2)} tras los tres filtros")print("derivadas que sobreviven:", [c for c in ("regla_2p", "tpsa_por_mw", "lipo_neta") if c inset(sub2)])
1 · casi constantes (un valor reúne ≥ 99% del entrenamiento): se descartan 24, quedan 182 de 206
    descartadas: NumRadicalElectrons, fr_Ar_COO, fr_C_S, fr_N_O, fr_SH, fr_alkyl_carbamate, fr_amidine, fr_azide, fr_azo, fr_diazo, fr_dihydropyridine, fr_epoxide, fr_hdrzine, fr_hdrzone, fr_morpholine, fr_nitro_arom, fr_nitro_arom_nonortho, fr_nitroso, fr_oxazole, fr_phos_acid, fr_phos_ester, fr_prisulfonamd, fr_quatN, fr_thiophene
    (el filtro anterior, varianza > 0.01 sobre Yeo-Johnson estandarizado, dejaba 205 de 206: toda columna tiene varianza 1, así que solo quitaba la constante)
2 · correlación de Spearman |ρ|>0.95: se descartan 31, quedan 151
    misma selección sobre estandarización : True
    misma selección sobre min-max         : True
    misma selección sobre Yeo-Johnson     : True
3 · información mutua: 15 descriptores no aportan nada sobre la etiqueta
   los cinco de mayor MI: MinAbsPartialCharge, MinPartialCharge, SlogP_VSA2, VSA_EState3, MolWt

de 206 descriptores a 151 tras los tres filtros
derivadas que sobreviven: ['regla_2p', 'tpsa_por_mw']
Código
# ¿cuánto cuesta cada reducción? se mide, no se suponeconjuntos = {f"todos ({len(nombres)})": (Atr, Ava),f"tras filtrado ({Btr.shape[1]})": (Btr, Bva),"mejores 50 por MI": (Btr[:, orden[:50]], Bva[:, orden[:50]]),}filas = []for nombre, (a, b) in conjuntos.items():for mod_n, mod in [("LogReg", LogisticRegression(max_iter=3000, random_state=42)), ("RF", RandomForestClassifier(n_estimators=200, random_state=42, n_jobs=-1))]: t0 = time.time() mod.fit(a, ytr) seg = time.time() - t0 pred = mod.predict(b) filas.append({"conjunto": nombre, "modelo": mod_n, "columnas": a.shape[1],"MCC": round(matthews_corrcoef(yva, pred), 3),"AUROC": round(roc_auc_score(yva, mod.predict_proba(b)[:, 1]), 3),"entrena (s)": round(seg, 1)})print(pd.DataFrame(filas).to_string(index=False))
           conjunto modelo  columnas   MCC  AUROC  entrena (s)
        todos (206) LogReg       206 0.484  0.823          0.0
        todos (206)     RF       206 0.589  0.920          0.4
tras filtrado (151) LogReg       151 0.497  0.829          0.0
tras filtrado (151)     RF       151 0.562  0.915          0.3
  mejores 50 por MI LogReg        50 0.484  0.802          0.0
  mejores 50 por MI     RF        50 0.534  0.909          0.3
Código
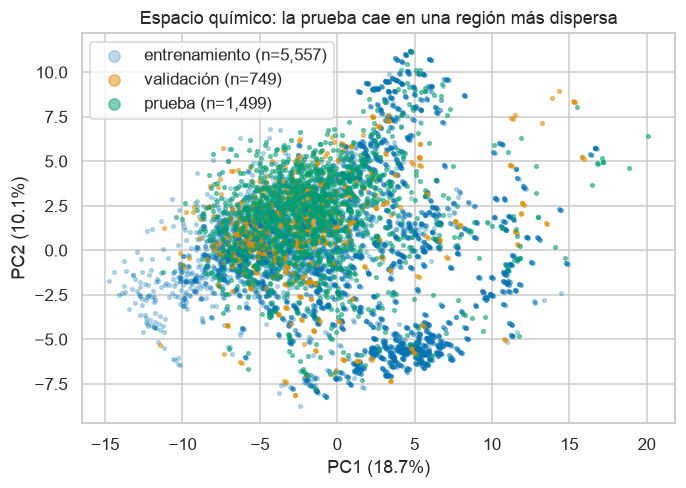
# El PCA es una herramienta de exploración, no un candidato: un componente es una# combinación lineal de las columnas y no se traduce a una subestructura, que es lo# que la explicabilidad exige. Aquí solo sirve para ver el espacio químico y comparar# la prueba con el entrenamiento; no decide nada y no se guarda.idx_te = np.where((d["particion"] =="prueba").values)[0]Bte = transformadores["Yeo-Johnson"].transform(X_desc[idx_te])[:, keep_var][:, keep_corr]pca_expl = PCA(n_components=2, random_state=42).fit(Btr)fig, ax = plt.subplots(figsize=(6.4, 4.6))for nombre_p, M, alfa in [("entrenamiento", Btr, 0.25), ("validación", Bva, 0.5), ("prueba", Bte, 0.5)]: z = pca_expl.transform(M) ax.scatter(z[:, 0], z[:, 1], s=6, alpha=alfa, label=f"{nombre_p} (n={len(z):,})")ax.set(xlabel=f"PC1 ({pca_expl.explained_variance_ratio_[0]:.1%})", ylabel=f"PC2 ({pca_expl.explained_variance_ratio_[1]:.1%})", title="Espacio químico: la prueba cae en una región más dispersa")ax.legend(markerscale=3)plt.tight_layout()plt.show()z_tr, z_te = pca_expl.transform(Btr), pca_expl.transform(Bte)print(f"dos componentes reúnen {pca_expl.explained_variance_ratio_.sum():.1%} de la varianza")print(f"dispersión (desviación estándar de PC1 y PC2) entrenamiento {z_tr.std(axis=0).round(2)}"f" prueba {z_te.std(axis=0).round(2)}")
dos componentes reúnen 28.8% de la varianza
dispersión (desviación estándar de PC1 y PC2)  entrenamiento [5.31 3.91]  prueba [4.03 2.68]
Reducir dimensión cuesta y no compensa. La comparación de arriba lo mide sobre la validación: con las 206 columnas la logística da 0.484 de MCC y el bosque 0.589; tras el filtrado, con 151, la logística sube a 0.497 y el bosque baja a 0.562; con las mejores 50 por información mutua caen las dos (0.484 y 0.534) y el ahorro de tiempo son décimas de segundo. Una sola partición de validación no distingue diferencias de ese tamaño —eso lo hace la validación cruzada agrupada de la sección 8.2—, así que lo que esta tabla aporta es la cota del costo, no la elección.
Decisión: la matriz de trabajo es la del filtrado, 151 columnas. Un componente principal es una combinación lineal de 151 columnas y no se traduce a una subestructura, así que adoptarlo rompería el requisito de explicabilidad que la patrocinadora puso como no negociable. No es un detalle de implementación: es el requisito que define el proyecto.
Por eso el PCA de arriba no es un brazo candidato, sino una vista del espacio químico: dos componentes reúnen el 28.8% de la varianza y dejan ver que la prueba cae en una región más dispersa que el entrenamiento, lo cual importa para leer el resultado del Avance 3. No se ajusta como modelo ni se guarda.
La selección por información mutua queda documentada y tampoco se aplica como corte duro, por la misma razón: con 50 columnas el MCC cae en los dos modelos.
10. Matriz final y guardado
Código
from scipy import sparse# los descriptores se guardan densos; los fingerprints, dispersosmeta = d[["compound_name", "SMILES", "Inchi", "y", "group", "natural","andamio", "esqueleto", "particion"]].copy()SALIDA = RAIZ /"data"/"processed"SALIDA.mkdir(parents=True, exist_ok=True)# el prefijo ya no lleva "ab": el conjunto es completo, sin filtro por grupofor viejo in SALIDA.glob("b3db_ab_*"): viejo.unlink()meta.to_parquet(SALIDA /"bbb_meta.parquet", index=False)desc_limpio.to_parquet(SALIDA /"bbb_descriptores.parquet", index=False)sparse.save_npz(SALIDA /"bbb_morgan2048.npz", sparse.csr_matrix(X_morgan))sparse.save_npz(SALIDA /"bbb_sortslice2048.npz", sparse.csr_matrix(X_ss))np.save(SALIDA /"bbb_sortslice_vocabulario.npy", np.array(ss.vocabulario, dtype=np.int64))# lo que producen las secciones 7 y 8: la matriz filtrada, su lista de columnas,# y los objetos ajustados SOLO con entrenamiento, sin los cuales no se puede# transformar un compuesto nuevoimport joblib# se transforma el conjunto COMPLETO con los objetos ajustados sobre# entrenamiento: eso no es fuga, es aplicar lo aprendido. Lo que sería fuga# es ajustarlos mirando validación o prueba, que es lo que no se hace.X_todo = transformadores["Yeo-Johnson"].transform(X_desc)desc_filtrado = pd.DataFrame(X_todo[:, keep_var][:, keep_corr], columns=sub2)desc_filtrado.to_parquet(SALIDA /"bbb_descriptores_filtrados.parquet", index=False)# La misma matriz SIN transformar: mismas columnas, mismo orden. El Avance 3# puede correr cualquiera de las dos sin recalcular nada, que es lo que mantiene# reversible la decisión 1.5 mientras siga abierta.desc_filtrado_crudo = pd.DataFrame(X_desc[:, keep_var][:, keep_corr], columns=sub2)desc_filtrado_crudo.to_parquet( SALIDA /"bbb_descriptores_filtrados_sin_normalizar.parquet", index=False)assertlist(desc_filtrado_crudo.columns) ==list(desc_filtrado.columns)joblib.dump({"escalador": transformadores["Yeo-Johnson"], "mascara_casi_constantes": keep_var, "mascara_correlacion": keep_corr,"columnas_tras_filtrado": list(sub2),"orden_informacion_mutua": list(sub2[orden])}, SALIDA /"bbb_preprocesamiento.joblib")cats.to_parquet(SALIDA /"bbb_categoricas_codificadas.parquet", index=False)for f insorted(SALIDA.iterdir()):print(f" {f.name:42}{f.stat().st_size/1e6:7.2f} MB")print(f"\nmatriz combinada: {len(meta)} filas x ({desc_limpio.shape[1]} descriptores + {X_morgan.shape[1]} bits Morgan)")
El vocabulario de Sort & Slice se guarda aparte: sin él no se puede transformar un compuesto nuevo, ni interpretar qué substructura representa cada columna.
11. Prueba de humo del pipeline
Un modelo mínimo para confirmar que las características y la partición funcionan. No es el modelo del Avance 3: sin ajuste de hiperparámetros, sin balanceo, sin selección de variables. Sirve para detectar errores de plomería, no para reportar desempeño.
Las métricas son MCC y AUPRC sobre la clase minoritaria (BBB−), no exactitud ni AUROC solos. El AUPRC de la clase positiva tendría línea base 0.720 —la proporción de BBB+ en la validación— y los valores parecerían buenos sin serlo.
Se evalúa sobre la validación, no sobre la prueba reservada: la prueba no se mira hasta la evaluación final (2.6). Una versión anterior de este notebook la usaba aquí.
Código
itr = (d["particion"] =="entrenamiento").valuesiva = (d["particion"] =="validacion").values # la prueba reservada no se miray = d["y"].valuesconjuntos = {"descriptores": desc_limpio.values,"Morgan": X_morgan,"Sort & Slice": X_ss,"descriptores + Morgan": np.hstack([desc_limpio.values, X_morgan]),}filas = []for nombre, X in conjuntos.items():for modelo, etiqueta in [ (make_pipeline(StandardScaler(), LogisticRegression(max_iter=2000, random_state=SEMILLA)), "LogReg"), (RandomForestClassifier(n_estimators=300, n_jobs=-1, random_state=SEMILLA), "RF"), ]: modelo.fit(X[itr], y[itr]) p = modelo.predict(X[iva]) s = modelo.predict_proba(X[iva])[:, 1] filas.append({"características": nombre, "modelo": etiqueta,"MCC": round(matthews_corrcoef(y[iva], p), 3),# AUPRC sobre la clase MINORITARIA (BBB−): la positiva es# la mayoritaria y su línea base es 0.720, casi el doble"AUPRC BBB−": round(average_precision_score(1- y[iva], 1- s), 3),"AUROC": round(roc_auc_score(y[iva], s), 3),"exactitud balanceada": round(balanced_accuracy_score(y[iva], p), 3)})base =1- y[iva].mean()print(f"línea base del AUPRC sobre BBB−: {base:.3f} (proporción de la clase minoritaria en la validación)")pd.DataFrame(filas).set_index(["características", "modelo"])
línea base del AUPRC sobre BBB−: 0.280 (proporción de la clase minoritaria en la validación)
MCC
AUPRC BBB−
AUROC
exactitud balanceada
características
modelo
descriptores
LogReg
0.459
0.701
0.814
0.714
RF
0.558
0.799
0.915
0.739
Morgan
LogReg
0.445
0.608
0.762
0.734
RF
0.518
0.763
0.875
0.702
Sort & Slice
LogReg
0.329
0.569
0.734
0.662
RF
0.542
0.750
0.866
0.726
descriptores + Morgan
LogReg
0.516
0.681
0.798
0.768
RF
0.594
0.824
0.924
0.746
Cómo NO leer esta tabla. Son números de una sola corrida, sin ajuste ni validación cruzada, sobre la validación, cuyos andamios no están en el entrenamiento. No se deben comparar con los 0.92 de AUROC del leaderboard de TDC, que usan otro conjunto y otra implementación del scaffold split. El Avance 3 hará la comparación con método.
Lo único que confirma esta tabla es que el pipeline corre y que las características tienen señal.
12. Conclusiones del Avance 2
12.0 La fase de preparación de datos en CRISP-ML(Q)
El proyecto sigue CRISP-ML(Q), que divide el ciclo en seis fases. Los Avances 1 y 2 cubren las dos primeras: entendimiento de los datos y preparación de los datos. Esta sección cierra la segunda.
CRISP-ML(Q) añade sobre CRISP-DM una exigencia de aseguramiento de calidad en cada fase: cada paso declara sus riesgos y cómo se mitigan. Aplicado a la preparación de datos, los riesgos que la metodología señala y lo que hicimos con cada uno:
Riesgo que señala CRISP-ML(Q)
Cómo se mitigó aquí
Evidencia
Fuga de información entre partición de entrenamiento y evaluación
Todo lo que aprende de los datos —vocabulario de Sort & Slice, escalador, selectores, PCA, umbral de TPSA— se ajusta solo con entrenamiento
La media del entrenamiento tras escalar es 0.0000 y la de evaluación 0.0048: si se hubiera ajustado sobre todo, ambas serían 0
Muestras no independientes
Partición por andamio agrupando por esqueleto de conectividad
Cero andamios y cero esqueletos cruzados entre particiones
Características redundantes que inflan la complejidad
Filtro de correlación tras confirmar los pares con |r| > 0.95
De 206 a 151 columnas no es gratis: el MCC del Random Forest sobre validación baja de 0.589 a 0.562, y el de la logística sube de 0.484 a 0.497. El filtrado ayuda al modelo lineal y le cuesta al de árboles
Datos que rompen el modelo en silencio
Auditoría de columnas por cuatro criterios
Ipc desborda float32 y un chequeo de isfinite no lo detecta
Decisiones no justificadas
Cada transformación y cada filtro se mide contra una alternativa antes de adoptarse
Tablas de las secciones 7.1, 7.2 y 8
Lo que queda documentado como deuda de esta fase, que es la otra mitad del aseguramiento de calidad:
La elección de transformación se deja abierta: con una sola corrida, min–max y Yeo-Johnson no se distinguen de forma concluyente. La matriz guardada asume Yeo-Johnson, porque el filtro de correlación y la información mutua se calculan sobre la versión transformada; cambiar de transformación obligaría a rehacer el filtrado.
El PCA se descarta por explicabilidad. La diferencia de MCC frente al filtrado no es concluyente: el intervalo de confianza por bootstrap cruza el cero, así que la decisión se sostiene por el requisito, no por el número.
Las comparaciones de método se hacen sobre validación, nunca sobre prueba, para no contaminar el conjunto con el que se reporta.
La fase siguiente —ingeniería del modelo, Avance 3— recibe una matriz de 7,805 compuestos, 151 columnas filtradas, 2,048 bits de fingerprint y una partición verificada, más los objetos de preprocesamiento ajustados para poder transformar compuestos nuevos sin volver a mirar la evaluación.
12.1 La partición funciona y no filtra
Partición
n
Andamios
Andamio mayor
% BBB+
entrenamiento
5,557
1,741
6.8%
64.0
validación
749
498
0.4%
72.0
prueba
1,499
1,390
0.1%
57.3
Cero andamios y cero esqueletos cruzados. La prueba tiene 1,390 andamios distintos en 1,499 compuestos: casi uno por molécula, que es exactamente lo que se busca en una evaluación de generalización estructural.
La prueba quedó con 57.3% BBB+ contra 64.0% del entrenamiento. No es un defecto de la partición: los andamios raros —los que quedan para evaluar— son menos permeables que los frecuentes. El modelo se evaluará sobre una distribución distinta de aquella en la que aprendió, que es justamente la situación realista.
La dirección de la asignación resultó ser el detalle crítico. Construida al revés —prueba llena de andamios frecuentes— daba 45 andamios con el benceno ocupando el 26%. Habría producido un número de desempeño que reflejaba tres quimiotipos.
12.2 Sin filtrar por grupo, el conjunto crece 67%
Pasar de A+B a las 7,805 filas etiquetadas suma 3,126 compuestos y, sobre todo, sube la clase minoritaria del 27.0% al 36.5%. Es la corrección del Avance 1: las categorías A–D no son una escala de calidad, y filtrarlas empeoraba el desbalance en lugar de depurar ruido.
El tamaño efectivo sigue siendo menor que el número de filas: los 7,805 compuestos corresponden a 4,018 esqueletos de conectividad. Al reportar el tamaño del entrenamiento hay que decir ambas cifras.
El 43.1% del conjunto son productos naturales, y esa marca viaja hasta la matriz final. El Avance 1 mostró que cruzan la barrera 18.9 puntos menos, así que el Avance 3 tendrá que reportar desempeño por separado en ambos grupos.
12.3 Ipc desborda float32
De los 217 descriptores quedan 203 utilizables. El descarte que importa es Ipc, el índice de contenido de información: alcanza ~1e41, finito en float64 pero por encima del máximo de float32, y Random Forest convierte internamente. Un chequeo de isfinite no lo detecta. Costó una ejecución fallida encontrarlo, y ahora está cubierto en limpiar_descriptores.
12.4 El umbral de TPSA se mueve otra vez
Medición
Umbral óptimo
Publicado (n=1,058, subconjunto con logBB)
66.8 Ų
Avance 1, sobre A+B (n=4,679)
83.6 Ų
Avance 1, sobre el conjunto completo (n=7,805)
101.9 Ų
Aquí, solo entrenamiento (n=5,557)
107.0 Ų
Cuatro subconjuntos del mismo dataset, cuatro umbrales que difieren en 40 Ų. El 66.8 Ų de la literatura no es una constante de la barrera hematoencefálica, es el óptimo de un subconjunto particular.
Para verificar las explicaciones del modelo se usará el umbral derivado del entrenamiento, y en la tesis se reportará sobre qué subconjunto se midió cada cifra.
12.5 El costo del scaffold split, medido
La caída de AUC entre entrenamiento y validación —la prueba no se mira (2.6):
Descriptor
Entrenamiento
Validación
Caída
TPSA
0.844
0.828
−0.016
NumHAcceptors
0.795
0.742
−0.053
NumHDonors
0.822
0.765
−0.057
MolWt
0.713
0.743
+0.030
MolLogP
0.744
0.594
−0.150
logP es el más frágil: pierde 0.150 y queda cerca del azar, así que su poder discriminante dependía de los andamios frecuentes. TPSA es el más robusto —pierde 0.016—, lo que refuerza usarlo como criterio principal de verificación. El peso molecular incluso sube, que es lo que pasa cuando un descriptor débil se mide en otro conjunto: 0.713 y 0.743 son la misma cifra con n = 749.
Una versión anterior medía esta caída sobre entrenamiento contra validación y prueba juntas, y daba caídas mayores (logP perdía 0.198). No es que la generalización haya mejorado: es otro conjunto de evaluación, el difícil, y mirarlo aquí gastaba la prueba reservada. Lo que no cambia es el orden: logP el más frágil, TPSA el más robusto.
12.6 Sort & Slice da la primera señal de dominio de aplicabilidad
n_bits
Cobertura entrenamiento
Cobertura prueba
Brecha
512
67.0%
53.4%
13.6
1,024
76.8%
61.2%
15.6
2,048
84.8%
68.0%
16.8
4,096
91.9%
74.1%
17.8
La brecha no se cierra al aumentar el vocabulario: crece. Eso significa que cerca de un tercio de las substructuras de la prueba simplemente no existen en el entrenamiento — es extrapolación estructural, no ruido. Se trabaja con 2,048 como compromiso, no porque sea un óptimo: la comparación de desempeño de la sección 5.1 mide que 4,096 es el mejor tamaño en los tres modelos, pero por diferencias pequeñas frente al ruido y a cambio de duplicar las columnas, mientras que la brecha de cobertura entre entrenamiento y prueba sigue creciendo con el tamaño.
Esta medida anticipa el problema que el marco teórico advierte para la etapa 2: los productos naturales estarán aún más lejos del dominio de entrenamiento que estos andamios raros.
12.7 La prueba de humo, con una advertencia sobre AUPRC
Sobre validación, no sobre la prueba reservada (2.6). Ordenada por MCC:
Características
Modelo
MCC
AUROC
descriptores + Morgan
RF
0.594
0.924
descriptores
RF
0.558
0.915
Sort & Slice
RF
0.542
0.866
Morgan
RF
0.518
0.875
descriptores + Morgan
LogReg
0.516
0.798
descriptores
LogReg
0.459
0.814
Morgan
LogReg
0.445
0.762
Sort & Slice
LogReg
0.329
0.734
Los descriptores solos superan a Morgan solo (MCC 0.558 contra 0.518), consistente con lo que reportaba la literatura, y combinarlos mejora las dos métricas (0.594 y 0.924), que es lo que sostiene la 1.3. El Random Forest queda por encima de la logística en las cuatro representaciones.
Estas cifras no se comparan con las de la versión anterior de este notebook, que evaluaba sobre la prueba reservada: ahí los andamios son raros y la tabla daba entre 0.282 y 0.358 de MCC. El conjunto cambió, no el pipeline.
Y nada de esto está asentado: sin ajuste de hiperparámetros ninguna de estas cifras decide nada. El Avance 3 es quien compara con método.
Cómo leer el AUPRC. Se calcula sobre la clase minoritaria (BBB−), cuya línea base es 0.280: ese es el valor que obtendría un modelo que no distingue nada. Una versión anterior de este notebook lo reportaba sobre la clase positiva, que es la mayoritaria y tiene línea base 0.720, de modo que los valores parecían mejores de lo que eran.
12.8 Lo que produce esta fase
Nueve artefactos en data/processed/, todos reproducibles ejecutando el notebook de principio a fin:
Archivo
Qué es
bbb_meta.parquet
identidad, etiqueta, origen natural, andamio y partición
bbb_descriptores.parquet
los 203 descriptores utilizables
bbb_descriptores_filtrados.parquet
las 151 tras casi constancia y correlación, escalados
bbb_descriptores_filtrados_sin_normalizar.parquet
las mismas 151, sin transformar, en el mismo orden
bbb_categoricas_codificadas.parquet
group y natural en one-hot, disponibles sin usarse
bbb_morgan2048.npz y bbb_sortslice2048.npz
los dos fingerprints
bbb_sortslice_vocabulario.npy
sin él no se puede transformar un compuesto nuevo
bbb_preprocesamiento.joblib
escalador, selectores y PCA ajustados solo con entrenamiento
Las dos versiones de la matriz filtrada existen porque la decisión 1.5 sigue abierta: ninguna de las decisiones de normalización y extracción está ratificada, y se revisan con la patrocinadora, que es quien decide antes del Avance 3.
12.9 Siguientes pasos
Avance 3 (03_Baseline.ipynb):
AUPRC sobre la clase minoritaria, no la mayoritaria.
Ajuste de hiperparámetros por validación cruzada, usando la partición de validación.
Control de Y-randomization contra correlación por azar.
Modelo interpretable simple entrenado en paralelo, como control de las explicaciones.
Desempeño reportado por separado en productos naturales y sintéticos, no solo global.
Tareas de datos:
Filtro PAINS antes de reportar cualquier candidato.
Resolver los 154 nombres de Spielvogel a SMILES para validación externa.
Revisar los 131 esqueletos con etiquetas contradictorias entre estereoisómeros.